이 코드는 어떤 문제를 푸나요?
eMMC와 UFS는 둘 다 블록 저장장치로 보이지만 명령을 보내는 하부 경로는 다릅니다. eMMC는 MMC 계층을, UFS는 SCSI 명령을 UPIU와 UFS 전송 구조로 바꾸는 경로를 사용합니다. 아래 코드는 UFS 쪽 ufshcd_queuecommand 전체입니다. 두 장치에 같은 레지스터나 같은 명령 형식이 적용된다고 설명하지 않습니다.
읽을 범위: v6.6 · drivers/ufs/core/ufshcd.c · ufshcd_queuecommand 2818–2908행입니다. 아래에 이 범위의 원문과 각 줄의 설명을 실었습니다. 주제 전체의 흐름과 다른 경로는 기존 분석에서 함께 읽으실 수 있습니다.
먼저 알아둘 개념
호스트와 장치
호스트 컨트롤러는 CPU 쪽에서 요청을 장치로 보내는 하드웨어입니다. hba는 UFS 호스트의 소프트웨어 상태이며 저장매체의 파일시스템 객체가 아닙니다.
SCSI 명령과 UPIU
UFS 드라이버는 상위 SCSI 요청의 명령·LUN·태그를 UFS 전송에 필요한 구조에 담습니다. eMMC의 MMC 명령 경로와 구분해야 합니다.
DMA 매핑
CPU가 보는 버퍼 주소를 장치 전송에 사용할 수 있게 준비하는 과정입니다. 흩어진 메모리는 scatter-gather 목록으로 표현하며 한 개의 연속 배열로 복사한다고 단정할 수 없습니다.
처음 읽을 때
정상 발행과 일시적으로 바빠 재시도하는 경우, 오류로 완료해 주는 경우를 나누어 읽으십시오. 반환값 0은 모든 경우에 장치가 성공적으로 데이터를 저장했다는 뜻이 아닙니다.
더 깊이 살펴볼 때
전원관리 중 발생한 치명적 오류에서 계속 HOST_BUSY만 반환하면 오류 복구와 전원관리 명령이 서로 기다릴 수 있습니다. scsi_done으로 명령을 오류 완료하는 분기의 이유와 hold/release 수명을 함께 확인하십시오.
그림으로 보는 변화
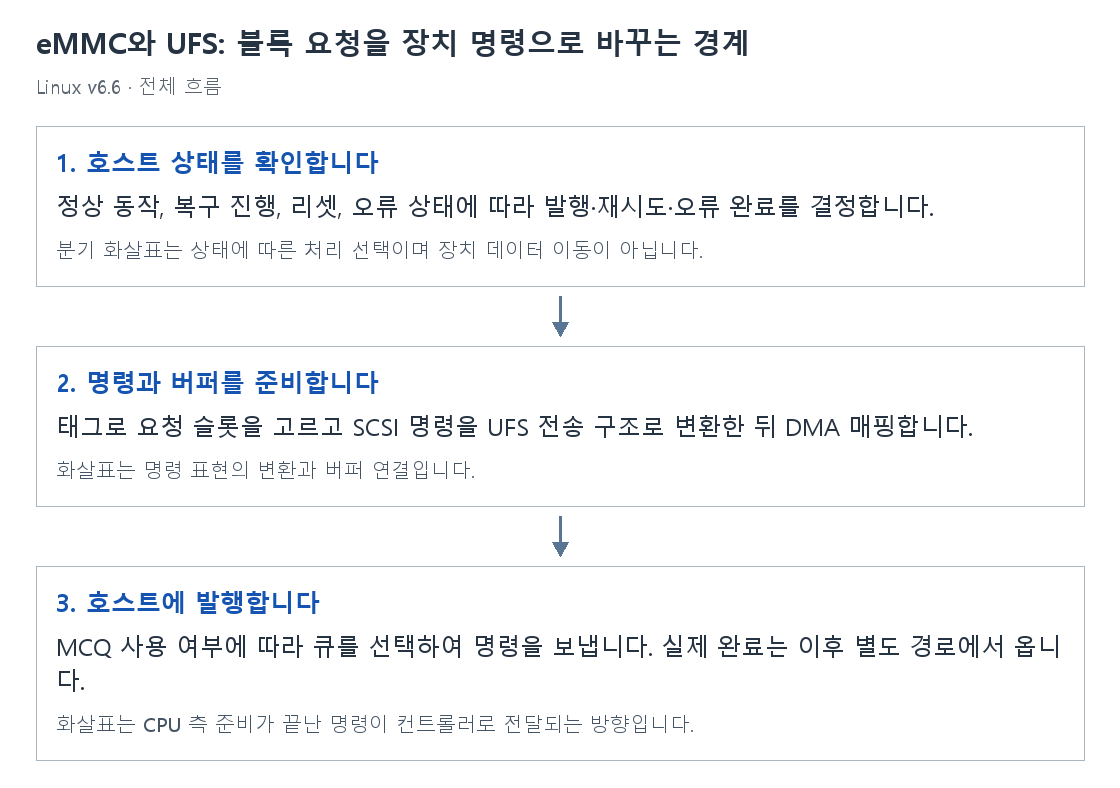
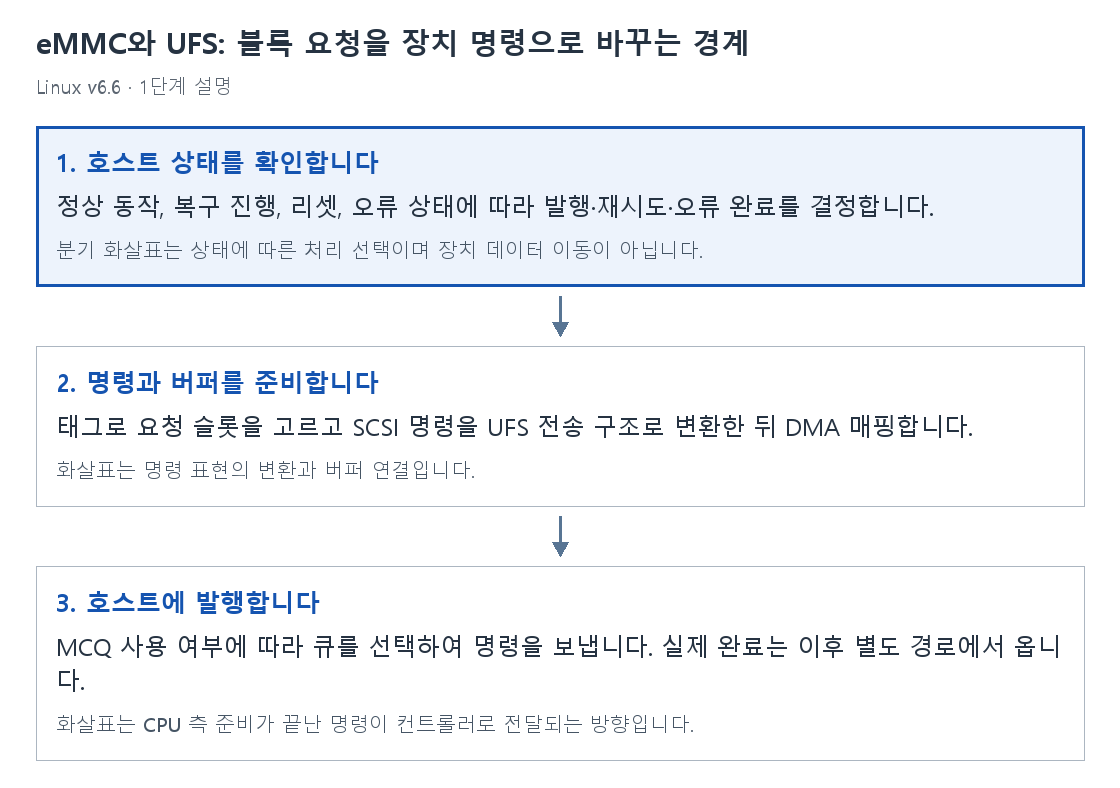
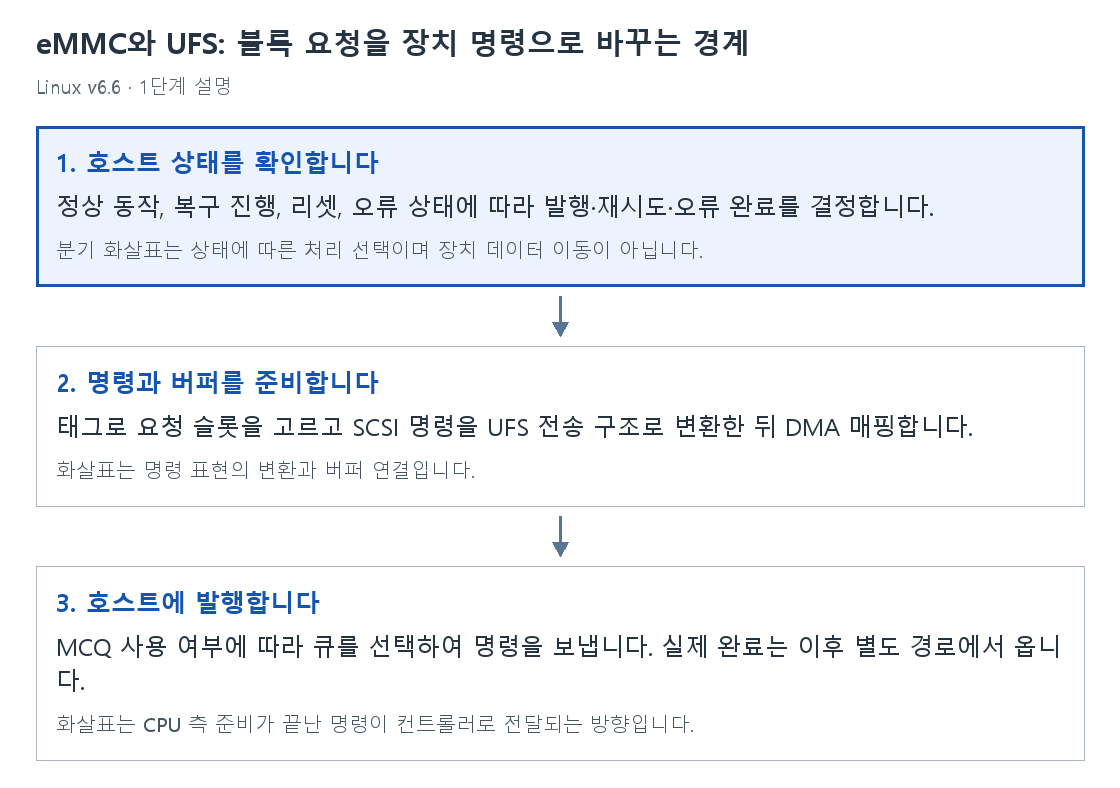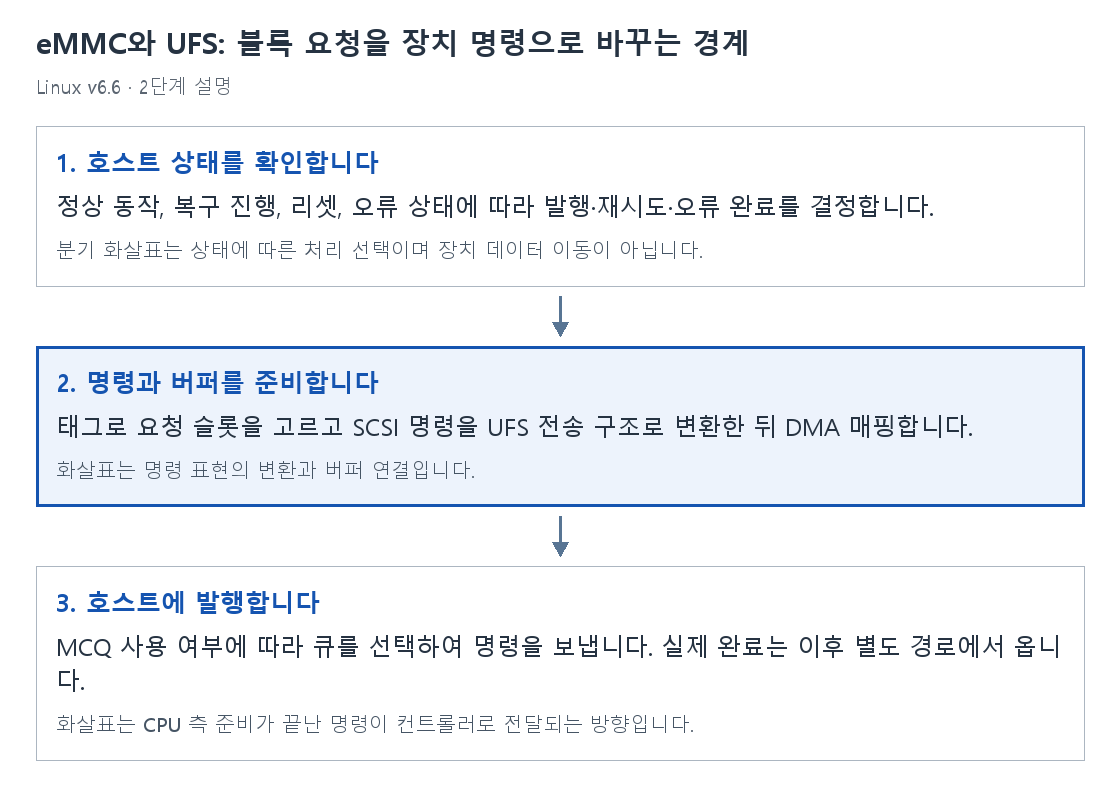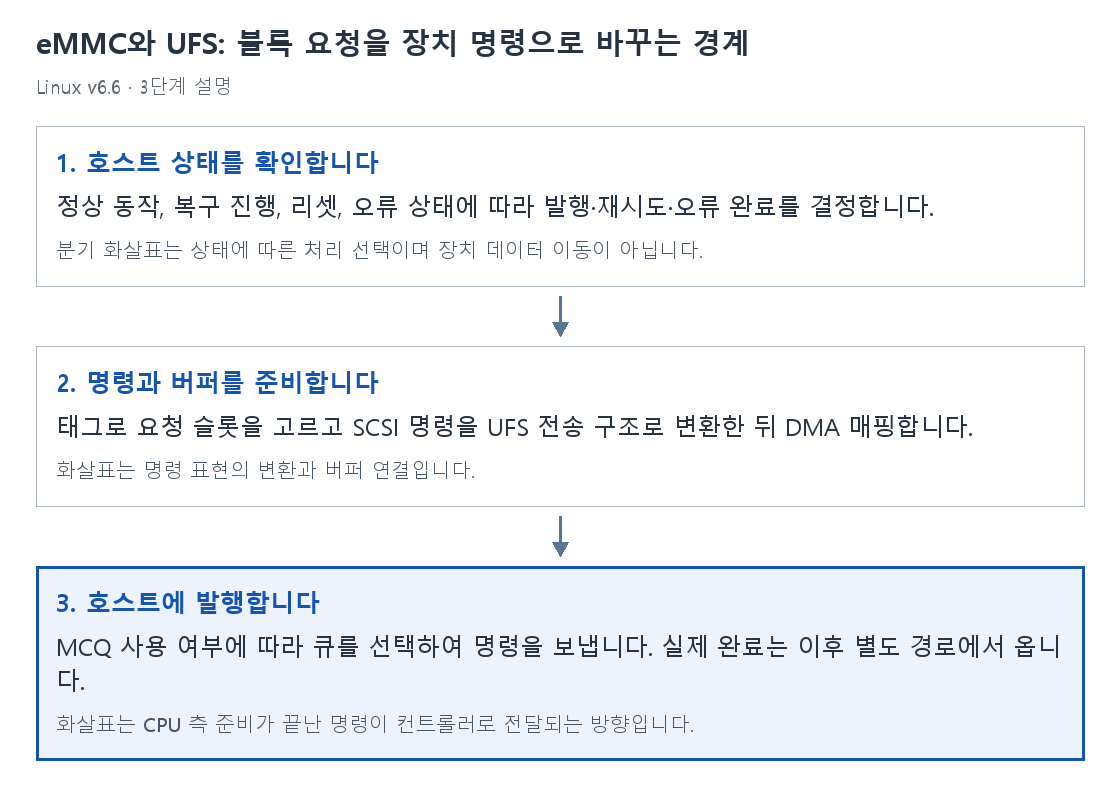
1. 호스트 상태를 확인합니다
정상 동작, 복구 진행, 리셋, 오류 상태에 따라 발행·재시도·오류 완료를 결정합니다.
분기 화살표는 상태에 따른 처리 선택이며 장치 데이터 이동이 아닙니다.
2. 명령과 버퍼를 준비합니다
태그로 요청 슬롯을 고르고 SCSI 명령을 UFS 전송 구조로 변환한 뒤 DMA 매핑합니다.
화살표는 명령 표현의 변환과 버퍼 연결입니다.
3. 호스트에 발행합니다
MCQ 사용 여부에 따라 큐를 선택하여 명령을 보냅니다. 실제 완료는 이후 별도 경로에서 옵니다.
화살표는 CPU 측 준비가 끝난 명령이 컨트롤러로 전달되는 방향입니다.
ufshcd_queuecommand를 한 줄씩 읽기
줄 번호는 v6.6 원문 기준입니다. 주석·빈 줄을 포함한 함수 전체를 먼저 보고, 그 아래에서 각 줄을 설명합니다.
static int ufshcd_queuecommand(struct Scsi_Host *host, struct scsi_cmnd *cmd)
{
	struct ufs_hba *hba = shost_priv(host);
	int tag = scsi_cmd_to_rq(cmd)->tag;
	struct ufshcd_lrb *lrbp;
	int err = 0;
	struct ufs_hw_queue *hwq = NULL;

	WARN_ONCE(tag < 0 || tag >= hba->nutrs, "Invalid tag %d\n", tag);

	switch (hba->ufshcd_state) {
	case UFSHCD_STATE_OPERATIONAL:
		break;
	case UFSHCD_STATE_EH_SCHEDULED_NON_FATAL:
		/*
		 * SCSI error handler can call ->queuecommand() while UFS error
		 * handler is in progress. Error interrupts could change the
		 * state from UFSHCD_STATE_RESET to
		 * UFSHCD_STATE_EH_SCHEDULED_NON_FATAL. Prevent requests
		 * being issued in that case.
		 */
		if (ufshcd_eh_in_progress(hba)) {
			err = SCSI_MLQUEUE_HOST_BUSY;
			goto out;
		}
		break;
	case UFSHCD_STATE_EH_SCHEDULED_FATAL:
		/*
		 * pm_runtime_get_sync() is used at error handling preparation
		 * stage. If a scsi cmd, e.g. the SSU cmd, is sent from hba's
		 * PM ops, it can never be finished if we let SCSI layer keep
		 * retrying it, which gets err handler stuck forever. Neither
		 * can we let the scsi cmd pass through, because UFS is in bad
		 * state, the scsi cmd may eventually time out, which will get
		 * err handler blocked for too long. So, just fail the scsi cmd
		 * sent from PM ops, err handler can recover PM error anyways.
		 */
		if (hba->pm_op_in_progress) {
			hba->force_reset = true;
			set_host_byte(cmd, DID_BAD_TARGET);
			scsi_done(cmd);
			goto out;
		}
		fallthrough;
	case UFSHCD_STATE_RESET:
		err = SCSI_MLQUEUE_HOST_BUSY;
		goto out;
	case UFSHCD_STATE_ERROR:
		set_host_byte(cmd, DID_ERROR);
		scsi_done(cmd);
		goto out;
	}

	hba->req_abort_count = 0;

	ufshcd_hold(hba);

	lrbp = &hba->lrb[tag];
	lrbp->cmd = cmd;
	lrbp->task_tag = tag;
	lrbp->lun = ufshcd_scsi_to_upiu_lun(cmd->device->lun);
	lrbp->intr_cmd = !ufshcd_is_intr_aggr_allowed(hba);

	ufshcd_prepare_lrbp_crypto(scsi_cmd_to_rq(cmd), lrbp);

	lrbp->req_abort_skip = false;

	ufshcd_comp_scsi_upiu(hba, lrbp);

	err = ufshcd_map_sg(hba, lrbp);
	if (err) {
		ufshcd_release(hba);
		goto out;
	}

	if (is_mcq_enabled(hba))
		hwq = ufshcd_mcq_req_to_hwq(hba, scsi_cmd_to_rq(cmd));

	ufshcd_send_command(hba, tag, hwq);

out:
	if (ufs_trigger_eh()) {
		unsigned long flags;

		spin_lock_irqsave(hba->host->host_lock, flags);
		ufshcd_schedule_eh_work(hba);
		spin_unlock_irqrestore(hba->host->host_lock, flags);
	}

	return err;
}static int ufshcd_queuecommand(struct Scsi_Host *host, struct scsi_cmnd *cmd)SCSI 호스트와 명령을 받아 UFS 장치에 보낼 준비를 합니다. 반환값은 명령 접수 또는 재시도 조건을 알립니다.
struct ufs_hba *hba = shost_priv(host);SCSI 호스트에 연결된 UFS 전용 상태를 꺼냅니다.
int tag = scsi_cmd_to_rq(cmd)->tag;SCSI 명령의 블록 request에서 태그를 얻어 UFS 요청 슬롯을 식별합니다.
struct ufshcd_lrb *lrbp;이번 명령이 사용할 UFS 로컬 요청 블록의 포인터입니다.
int err = 0;기본 반환값은 명령을 접수했다는 0입니다. 장치 완료 성공과 동일한 뜻은 아닙니다.
struct ufs_hw_queue *hwq = NULL;MCQ 큐 선택 전에는 하드웨어 큐 포인터를 NULL로 둡니다.
WARN_ONCE(tag < 0 || tag >= hba->nutrs, "Invalid tag %d\n", tag);태그가 호스트 요청 슬롯 범위 안인지 한 번 경고합니다. WARN_ONCE만으로 잘못된 태그를 수정하거나 함수를 즉시 종료하지는 않습니다.
switch (hba->ufshcd_state) {호스트의 현재 동작·복구 상태에 따라 명령 처리 방식을 고릅니다.
case UFSHCD_STATE_OPERATIONAL:정상적으로 명령을 처리할 수 있는 상태입니다.
break;상태 검사만 끝내고 아래 명령 준비를 계속합니다.
case UFSHCD_STATE_EH_SCHEDULED_NON_FATAL:치명적이지 않은 오류 복구가 예약된 상태를 처리합니다.
if (ufshcd_eh_in_progress(hba)) {복구가 실제로 진행 중인지 확인해 리셋 도중 명령이 끼어들지 않게 합니다.
err = SCSI_MLQUEUE_HOST_BUSY;상위 SCSI 계층에 호스트가 바쁘므로 재시도해야 한다고 알릴 값을 설정합니다.
goto out;새 명령을 만들지 않고 공통 종료 절차로 갑니다.
break;복구가 진행 중이 아니면 명령 준비를 계속할 수 있습니다.
case UFSHCD_STATE_EH_SCHEDULED_FATAL:치명적 오류 복구가 예약된 상태를 구분합니다.
if (hba->pm_op_in_progress) {전원관리 동작 중 발행된 명령인지 검사합니다. 복구와 전원관리가 서로 기다리는 상황을 피해야 합니다.
hba->force_reset = true;이후 복구에서 강제 리셋이 필요하다는 상태를 표시합니다.
set_host_byte(cmd, DID_BAD_TARGET);현재 명령에 DID_BAD_TARGET 호스트 오류를 기록합니다.
scsi_done(cmd);이 명령을 즉시 오류 완료해 상위 계층이 계속 기다리지 않게 합니다.
goto out;이미 완료했으므로 실제 장치 발행은 건너뜁니다.
fallthrough;전원관리 특수 처리가 아니면 다음 RESET 처리와 같은 재시도 경로를 사용합니다. 의도한 switch 낙하를 명시한 표기입니다.
case UFSHCD_STATE_RESET:호스트 리셋 중인 상태입니다.
err = SCSI_MLQUEUE_HOST_BUSY;아직 발행할 수 없으므로 HOST_BUSY를 선택합니다.
goto out;발행 준비를 건너뜁니다.
case UFSHCD_STATE_ERROR:호스트가 오류 상태인 경우입니다.
set_host_byte(cmd, DID_ERROR);명령에 일반 호스트 오류 DID_ERROR를 저장합니다.
scsi_done(cmd);오류 결과로 명령을 완료합니다.
goto out;이미 완료한 명령을 아래에서 다시 발행하지 않습니다.
hba->req_abort_count = 0;새 정상 요청을 처리하며 요청 중단 시도 계수를 초기화합니다.
ufshcd_hold(hba);명령 처리 동안 필요한 호스트 동작 상태를 유지하도록 hold를 얻습니다.
lrbp = &hba->lrb[tag];태그를 배열 인덱스로 사용해 해당 요청 슬롯을 고릅니다. 태그는 장치 섹터 주소가 아닙니다.
lrbp->cmd = cmd;이 슬롯을 완료 처리할 때 원래 SCSI 명령으로 돌아갈 수 있도록 cmd 포인터를 연결합니다.
lrbp->task_tag = tag;전송을 식별할 태스크 태그를 요청 블록에도 저장합니다.
lrbp->lun = ufshcd_scsi_to_upiu_lun(cmd->device->lun);SCSI 장치의 LUN을 UFS UPIU 형식의 논리 장치 번호로 변환해 넣습니다.
lrbp->intr_cmd = !ufshcd_is_intr_aggr_allowed(hba);인터럽트를 모아 처리하는 방식이 허용되지 않을 때 이 명령의 개별 인터럽트 처리를 요청하도록 표시합니다.
ufshcd_prepare_lrbp_crypto(scsi_cmd_to_rq(cmd), lrbp);블록 요청의 인라인 암호화 정보를 확인해 UFS 요청 블록에 필요한 암호화 문맥을 준비합니다.
lrbp->req_abort_skip = false;새 요청에 대해 중단 절차를 건너뛴다는 표시를 초기화합니다.
ufshcd_comp_scsi_upiu(hba, lrbp);명령과 LUN 등 앞서 준비한 정보를 바탕으로 SCSI 명령용 UPIU 전송 구조를 구성합니다.
err = ufshcd_map_sg(hba, lrbp);데이터 버퍼의 scatter-gather 목록을 DMA 전송에 맞게 매핑합니다.
if (err) {매핑에 실패했는지 확인합니다.
ufshcd_release(hba);발행하지 못하므로 앞서 얻은 호스트 hold를 내려놓습니다.
goto out;오류를 보존한 채 종료합니다.
if (is_mcq_enabled(hba))이 호스트에서 MCQ가 활성화됐는지 도우미 함수로 확인합니다.
hwq = ufshcd_mcq_req_to_hwq(hba, scsi_cmd_to_rq(cmd));블록 request가 사용할 UFS 하드웨어 큐를 결정합니다.
ufshcd_send_command(hba, tag, hwq);준비한 태그와 큐로 실제 명령 발행을 요청합니다. 완료를 기다리는 호출로 읽으면 안 됩니다.
out:접수, 재시도, 오류 완료 경로가 모입니다.
if (ufs_trigger_eh()) {오류 복구 작업을 유도하는 조건이 있는지 검사합니다. 이 버전의 ufs_trigger_eh 호출에는 hba 인자가 없습니다.
unsigned long flags;잠금을 잡기 전의 인터럽트 상태를 보관할 변수입니다.
spin_lock_irqsave(hba->host->host_lock, flags);인터럽트 상태를 보존하고 호스트 잠금을 잡아 복구 예약 상태를 보호합니다.
ufshcd_schedule_eh_work(hba);오류 복구 작업을 예약합니다.
spin_unlock_irqrestore(hba->host->host_lock, flags);호스트 잠금을 풀고 원래 인터럽트 상태를 복구합니다.
return err;명령을 받아들였는지 또는 재시도가 필요한지 상위 SCSI 계층에 알립니다.
함께 생각해 볼 질문
UFS와 eMMC의 블록 계층 위쪽은 공유할 수 있나요?
공통 블록 장치 인터페이스를 제공할 수 있지만 그 아래의 명령 형식과 호스트 드라이버 경로는 다릅니다.
HOST_BUSY이면 명령을 오류 완료했나요?
이 값은 상위 계층에 나중에 다시 제출하도록 알리는 경우입니다. scsi_done으로 완료한 경로와 구분해야 합니다.
ufshcd_send_command 뒤 데이터가 영구 저장됐나요?
발행했음을 뜻합니다. 완료 응답과 캐시 flush 등 영속성 조건은 별도로 확인해야 합니다.
출처와 읽은 범위
Linux stable v6.6 · drivers/ufs/core/ufshcd.c
해당 버전 원본 파일 · 기존 코드 분석 · 설명 원고