File을 mmap()한 뒤 file descriptor를 닫으면 pointer도 사용할 수 없게 될까요? File이 unlink()되거나 길이가 줄어드는 경우는 어떨까요? 이 질문들은 모두 file mapping에 관한 것이지만, 같은 종류의 수명 문제는 아닙니다.
Linux의 일반적인 file mapping을 기준으로, 주소 범위와 backing file, 열린 descriptor를 나누어 살펴보겠습니다. Device mapping처럼 별도 동작을 구현하는 mapping에는 그대로 적용할 수 없는 부분이 있습니다.
여섯 인자가 결정하는 것
void *mmap(void *addr, size_t length, int prot, int flags,
           int fd, off_t offset);
mmap()은 시작 주소에 관한 요청, 길이, protection, flags, file descriptor, file offset을 받습니다. addr를 NULL로 전달하면 kernel이 위치를 선택합니다. length는 0보다 커야 하며 일반적인 mapping 범위는 page 경계에 맞추어 관리됩니다. File offset은 page 크기에 맞게 정렬해야 합니다.
PROT_READ, PROT_WRITE, PROT_EXEC는 접근 권한을 지정합니다. MAP_PRIVATE와 MAP_SHARED는 수정의 공유 방식에 관한 선택입니다. Protection과 sharing을 같은 것으로 읽으시면 안 됩니다. 예를 들어 MAP_SHARED라도 write protection이 없으면 쓰기 가능한 mapping이 아닙니다.
Linux의 MAP_SHARED_VALIDATE는 shared mapping에서 알 수 없는 flag를 무시하지 않고 검사하도록 하는 선택입니다. 지원하지 않는 flag에는 EOPNOTSUPP로 실패할 수 있으며, MAP_SYNC처럼 이 mode가 필요한 기능도 있습니다. Application의 data 동기화나 file truncate의 안전성까지 검증하는 flag는 아닙니다.
실패한 결과는 NULL이 아니라 MAP_FAILED와 비교해야 합니다. errno에는 실패 원인이 남습니다. 반환 주소를 확인하지 않고 접근하면 mapping 실패를 잘못된 memory 접근으로 바꾸게 됩니다.
Anonymous mapping에서는 MAP_ANONYMOUS를 사용하며 일반적으로 fd는 -1, offset은 0으로 둡니다. 일반적인 anonymous private mapping은 범위가 생겼다는 이유만으로 모든 data pages를 즉시 확보하는 것이 아닙니다. 최초 접근과 fault의 동작은 mapping을 만드는 API 호출과 별도로 이해해야 합니다.
Linux에서 MAP_ANON은 MAP_ANONYMOUS의 별칭으로 쓰입니다. 새로 만든 anonymous memory는 0으로 초기화된 내용을 제공하지만, 이것을 mapping 순간에 모든 physical page를 따로 allocation한다는 뜻으로 읽어서는 안 됩니다.
File descriptor를 닫는 것과 unmap은 다릅니다
File mapping을 만들면 kernel은 mapping에 필요한 file 참조를 유지합니다. 따라서 성공한 mmap() 이후에 file descriptor를 닫아도 그것만으로 기존 mapping이 사라지지는 않습니다. Descriptor table의 항목과 VMA가 보유한 참조는 다릅니다.
반대로 descriptor가 열려 있어도 munmap()한 주소에 계속 접근할 수는 없습니다. munmap()은 지정한 주소 범위의 mapping을 제거합니다. 하나의 mapping 전체만 해제할 수 있는 것은 아니며, 범위에 따라 기존 VMA가 분리되거나 여러 mapping이 함께 제거될 수 있습니다.
unlink()도 별개입니다. 이름으로 file을 찾는 directory entry를 제거하는 일과 이미 참조 중인 inode 및 mapping을 없애는 일은 다릅니다. 다만 다른 process가 file의 내용을 변경하거나 truncate하는 일까지 차단해 주는 것은 아닙니다.
MAP_SHARED는 쓰기를 공유하지만 완료 시점까지 보장하지 않습니다
일반적인 shared file mapping을 통해 수정한 data는 backing file의 page cache와 연결됩니다. 다른 mapping과 file I/O에서의 관찰, dirty tracking과 writeback이 이 경로에 관여합니다. Memory store가 끝난 것과 저장 장치에 대한 persistence 작업이 끝난 것은 같은 시점이 아닙니다.
msync()의 MS_SYNC는 지정 범위의 동기화를 기다리는 데 사용합니다. MS_ASYNC를 단순히 “지금 반드시 별도 쓰기 작업을 시작하는 명령”으로 읽으시면 안 됩니다. Linux에서는 이미 dirty tracking과 background writeback이 이루어집니다. MS_INVALIDATE도 모든 process의 memory를 강제로 초기화하는 만능 명령은 아닙니다.
munmap()을 호출했다는 사실만으로 MS_SYNC와 동일한 동기화 완료를 가정할 수 없습니다. 또한 msync()의 의미만으로 새 directory entry나 다른 file의 metadata까지 포함한 전체 transaction의 crash consistency를 설명할 수는 없습니다. Application의 내구성 요구는 file 및 filesystem의 동기화 규칙과 함께 검토해야 합니다.
File 끝과 page 끝은 같지 않을 수 있습니다
File 길이가 page 크기의 배수가 아니면 마지막 page에는 file 밖의 나머지 공간이 생깁니다. 그 부분을 file 크기 안의 유효 data로 취급하거나, 거기에 store하면 file이 자동으로 늘어난다고 가정해서는 안 됩니다. Linux에는 page cache에 관한 세부 동작과 예외도 있으므로 임시 저장 공간으로 사용하는 방식도 피하시는 편이 좋습니다.
마지막 partial page의 file 밖 부분은 처음에는 0으로 채워지고, 그 범위에 대한 변경이 file 끝을 늘리며 writeback되는 것은 아닙니다. 그렇다고 store가 아무 효과도 없다고 설명해서도 안 됩니다. Linux에서는 그런 data가 page cache에 남아 뒤의 mapping에서 보일 수 있는 경우가 있습니다. 특히 tmpfs 등의 예외를 생각하면 file 밖의 tail을 application의 숨은 저장 공간으로 사용해서는 안 됩니다.
Mapping 범위가 file보다 크거나 file이 줄어들면, 범위 자체는 존재해도 접근한 page에 유효한 backing이 없을 수 있습니다. File 끝을 벗어난 page에 대한 접근에서는 SIGBUS가 발생할 수 있습니다. File-backed fault가 I/O 오류로 실패하는 경우에도 정상적인 data pointer처럼 사용할 수 없는 상황이 생깁니다.
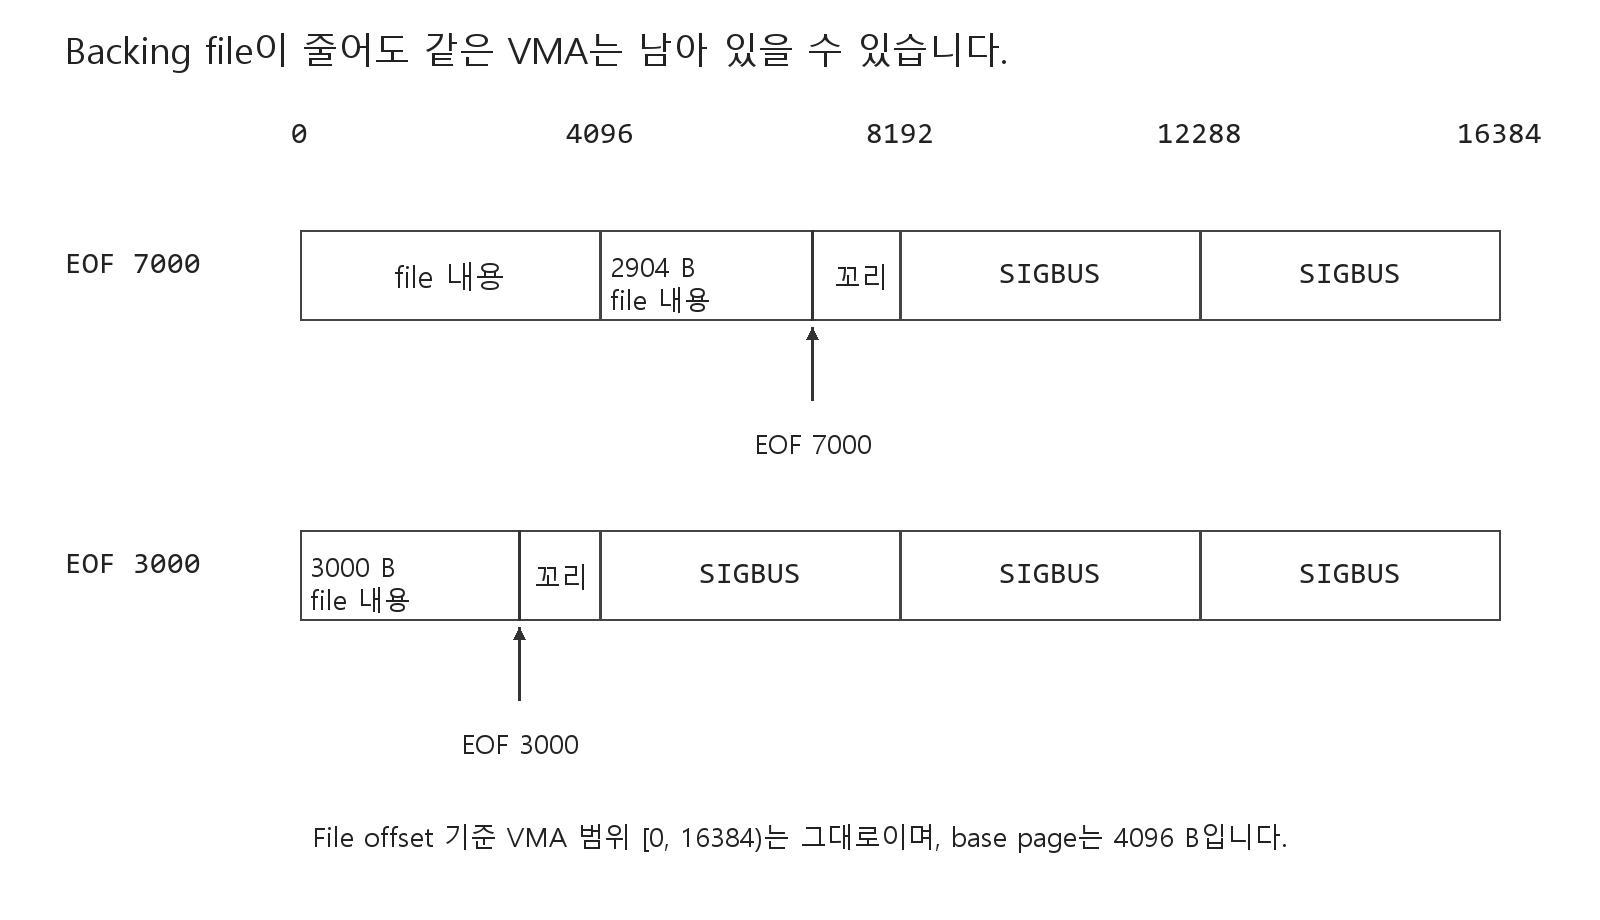
즉, mapping 생성이 성공했다는 사실이 앞으로 그 범위의 모든 접근이 성공한다는 보증은 아닙니다. 특히 다른 process가 같은 file을 truncate할 수 있는 설계에서는 길이 확인 한 번만으로 이후 접근의 안전성이 확보되지 않습니다.
MAP_PRIVATE는 file의 영구 snapshot이 아닙니다
Private file mapping의 write는 Copy-on-Write를 통해 anonymous memory 쪽의 수정으로 이어집니다. 이 수정이 원래 file에 writeback되는 것은 아닙니다. 아직 CoW하지 않은 page와 이미 private copy를 가진 page의 상태도 같지 않습니다.
여기서 MAP_PRIVATE를 “다른 process의 file 변경으로부터 완전히 독립적인 snapshot”이라고 이해하면 곤란합니다. 외부 수정의 가시성은 API가 일반적인 snapshot 규칙으로 보장하는 것이 아니고, truncate는 backing 범위와 fault에 영향을 줍니다. 크기를 줄인 뒤 다시 키우는 동작을 평범한 overwrite와 동일하게 취급해서도 안 됩니다.
일반적인 page-cache file에서 새 EOF를 완전히 넘어가는 page를 생각해 보겠습니다. 이미 private write로 CoW하여 anonymous copy를 가지고 있어도, truncate가 그 범위의 mapping을 invalidation할 때 해당 PTE까지 제거될 수 있습니다. 이 수정분은 원래 file에 저장된 것이 아니므로 함께 잃을 수 있고, file이 줄어든 상태에서 다시 접근하면 SIGBUS가 발생할 수 있습니다. 나중에 file을 늘린다고 사라진 private 수정분이 복구되는 것도 아닙니다.
Linux v6.12의 truncate_pagecache()는 이 과정에서 private CoW mapping도 제거하는 unmap_mapping_range() 호출을 사용합니다. 이 조건을 평범한 file overwrite가 언제나 모든 private copy를 초기화한다는 뜻으로 확장해서는 안 됩니다.
따라서 private copy를 보존해야 한다면 해당 file의 변경 규약을 함께 정하거나, 필요한 data를 명시적으로 별도 memory에 복사하는 방식 등을 검토해야 합니다. 단순히 MAP_SHARED를 MAP_PRIVATE로 바꾸는 것만으로 모든 외부 변경의 영향을 제거할 수는 없습니다.
MAP_FIXED는 기존 mapping을 대체할 수 있습니다
MAP_FIXED가 없을 때 addr는 일반적으로 위치에 관한 hint입니다. 반면 MAP_FIXED는 지정한 위치를 사용하며 겹치는 기존 mapping을 대체할 수 있습니다. 현재 빈 공간으로 보인 주소를 조사한 뒤 나중에 덮어쓰는 방식은, 그 사이 다른 thread가 mapping을 만들 수 있어 위험합니다.
원하는 위치가 이미 사용 중이면 실패하기를 원할 때는 MAP_FIXED_NOREPLACE가 목적에 가깝습니다. 이 기능을 지원하지 않는 오래된 kernel과의 호환성이 필요하다면, 반환된 주소가 요청과 같은지도 확인해야 합니다.
Custom allocator처럼 큰 주소 범위 안에서 위치를 관리하려면, 먼저 PROT_NONE mapping으로 자신의 범위를 예약하고 그 내부를 계획에 따라 대체하는 설계가 가능합니다. 접근할 수 없는 예약 범위와 실제 data를 쓸 수 있도록 만든 부분은 다릅니다. 또한 큰 예약 범위도 address-space limit이나 mapping 관련 제약에서 완전히 자유로운 것은 아닙니다.
어떤 방식을 사용하든 주소를 관리하는 주체와 동기화 규칙이 필요합니다. File descriptor의 소유권, mapping 범위의 소유권, backing data의 변경 권한을 각각 정해 두어야 수명 문제가 섞이지 않습니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access edition, 2025, §14.3.
- Linux man-pages
mmap(2) - Linux man-pages
msync(2) - Linux v6.12
mm/mmap.c - Linux v6.12
mm/truncate.c,truncate_pagecache()