free에서 free 값은 작고 buff/cache는 큰 상황을 보셨을 수 있습니다. 사용되지 않는 RAM만 allocation에 쓸 수 있다면 곧 memory가 부족해질 것 같습니다. 하지만 kernel은 필요할 때 회수할 수 있는 memory도 사용 가능량을 추정할 때 고려합니다.
여기서는 Linux v6.12의 si_mem_available()과 procfs를 기준으로 MemAvailable의 계산을 살펴보겠습니다. 이 값은 앞으로 실행할 프로그램의 allocation 성공을 보증하는 수치가 아니라, swapping 없이 사용할 수 있는 memory에 대한 추정입니다.
free의 숫자를 /proc/meminfo로 되짚습니다
우선 조회만 하는 명령으로 같은 시점의 항목을 비교하시면 됩니다. 아래 명령은 설정을 변경하지 않습니다.
free -h
cat /proc/meminfo
cat /proc/buddyinfo
free의 기본 출력 단위는 보통 KiB이며, -h는 크기에 따라 단위를 바꾸어 표시합니다. /proc/meminfo에서 표기하는 kB는 이 문맥에서는 1,024 bytes 단위입니다. 서로 다른 단위의 화면을 그대로 빼거나 더하면 맞지 않는 것처럼 보일 수 있습니다.
책에서 설명하는 출력 항목의 대응 관계는 다음과 같습니다. free 자체의 version에 따라서도 표시 방식이 달라질 수 있으므로, 도구의 출력과 kernel의 원래 항목을 구분해서 읽으시는 편이 좋습니다.
| 출력 항목 | 주로 대응하는 항목과 의미 |
|---|---|
total |
MemTotal. Kernel이 사용 가능한 것으로 관리하는 physical memory이며, 장착된 RAM 전체와 같다고 보장하지 않습니다. |
free |
MemFree. 현재 어떤 용도로도 사용하지 않는 memory입니다. |
available |
MemAvailable. Reserve와 회수 가능량을 고려한 추정입니다. |
used |
책의 계산 기준에서는 MemTotal - MemAvailable입니다. |
shared |
Shmem. tmpfs 등을 포함하는 shmem memory입니다. 모든 종류의 공유 mapping을 합한 수치가 아닙니다. |
buff/cache |
책의 계산 기준에서는 Buffers + Cached + SReclaimable입니다. 전부 즉시 회수할 수 있다는 뜻은 아닙니다. |
Buffers는 block device의 buffer 용도 memory를 나타냅니다. Cached는 file cache의 관련 통계에서 swap cache와 buffer에 해당하는 부분 등을 제외한 값으로 계산됩니다. SReclaimable은 slab 중 회수 가능한 것으로 분류된 부분입니다. 이미 사용 중이라는 사실과 앞으로 회수할 수 있다는 사실은 모순되지 않습니다.
아래는 단위와 열의 관계를 비교하기 위해 만든 설명용 출력이며 실제 측정 결과가 아닙니다. free -k로 KiB 단위를 명시한 경우입니다. 같은 예시의 meminfo에서는 관련 필드만 골라 적었습니다.
               total   used   free  shared  buff/cache  available
Mem:           65536  24576  16384    1024       25088      40960
Swap:           8192   2048   6144

MemTotal:       65536 kB
MemFree:        16384 kB
MemAvailable:   40960 kB
Buffers:         512 kB
Cached:        20480 kB
Shmem:          1024 kB
SReclaimable:   4096 kB
SwapTotal:      8192 kB
SwapFree:       6144 kB
이 계산 기준에서 used는 65536 - 40960 = 24576 KiB, buff/cache는 512 + 20480 + 4096 = 25088 KiB입니다. used + free + buff/cache를 total과 같게 만드는 방식으로 역산해서는 안 됩니다. used가 available의 추정을 이용하기 때문입니다. free -h는 같은 크기를 사람이 읽기 쉬운 단위로 반올림해 표시하므로, 이미 반올림된 화면끼리 정확한 합계를 맞추려 하지 않는 편이 좋습니다.
Free pages에서도 reserve를 제외합니다
si_mem_available()은 먼저 모든 zone의 low watermark를 합합니다. 이를 여기서는 L이라고 하겠습니다. 이어 free pages에서 totalreserve_pages를 뺀 값을 계산의 출발점으로 삼습니다.
totalreserve_pages에는 zone watermark와 lowmem reserve에 관한 제약이 반영됩니다. 따라서 L과 totalreserve_pages를 같은 수치로 바꾸어 쓰시면 안 됩니다. 전자는 뒤에서 회수 가능량을 보수적으로 계산하는 데 쓰이고, 후자는 처음부터 userspace에 모두 내줄 수 없는 reserve를 제외하는 데 쓰입니다.
예를 들어 free가 40 MiB이고 이 계산에 적용되는 reserve가 20 MiB라면, 첫 항은 20 MiB입니다. 이는 설명을 위한 독립적인 수치이며 실제 장비에서 측정한 결과는 아닙니다.
Page cache도 전부 회수한다고 가정하지 않습니다
다음으로 NR_ACTIVE_FILE과 NR_INACTIVE_FILE을 더해 file LRU의 크기를 구합니다. 여기서 일정량을 남기고 나머지만 available에 더합니다. Cache를 전부 비우면 다시 읽는 I/O가 늘어나고 thrashing이 생길 수 있기 때문입니다.
남기는 양은 file LRU 크기의 절반과 L 중 작은 값입니다. 예를 들어 file LRU가 80 MiB이고 L이 12 MiB라면, 40 MiB와 12 MiB 중 작은 12 MiB를 남기고 68 MiB를 더합니다. 항상 절반을 남기는 것도, 항상 low watermark 전체를 남기는 것도 아닙니다.
Shmem은 file 형태로 접근할 수 있어도 이 계산에서 일반적인 clean file cache처럼 취급할 수 없습니다. 내용이 RAM에만 있다면 저장된 file data를 다시 읽는 방식으로 복구할 수 없기 때문입니다. LRU와 reclaim에서는 swap-backed anonymous memory 쪽의 특성을 가지며, Cached 화면의 숫자를 이 함수의 file LRU 값과 그대로 동일시하면 안 됩니다.
Reclaimable kernel memory를 더합니다
Linux v6.12 구현은 reclaimable slab뿐 아니라 NR_KERNEL_MISC_RECLAIMABLE도 포함합니다. Slab counter는 byte 기반 항목을 page 단위로 바꾸어 합산합니다. 서로 다른 단위의 counter를 그대로 더하지 않는다는 점도 source를 읽을 때 확인할 부분입니다.
이 kernel reclaimable 합계에서도 절반과 L 중 작은 값을 남깁니다. Reclaimable로 분류되었다고 해서 지금 당장 모든 object를 버릴 수 있는 것은 아닙니다. 마지막 결과가 음수이면 0으로 제한합니다.
다음은 실제 kernel code의 복사본이 아니라 계산 관계만 나타낸 수식입니다. F, R, C, K, L은 모두 같은 단위로 환산한 값입니다.
F = free memory
R = totalreserve_pages
C = active_file + inactive_file
K = reclaimable slab + other reclaimable kernel memory
L = sum of zone low watermarks

available = max(0,
    F - R + C - min(C / 2, L) + K - min(K / 2, L))
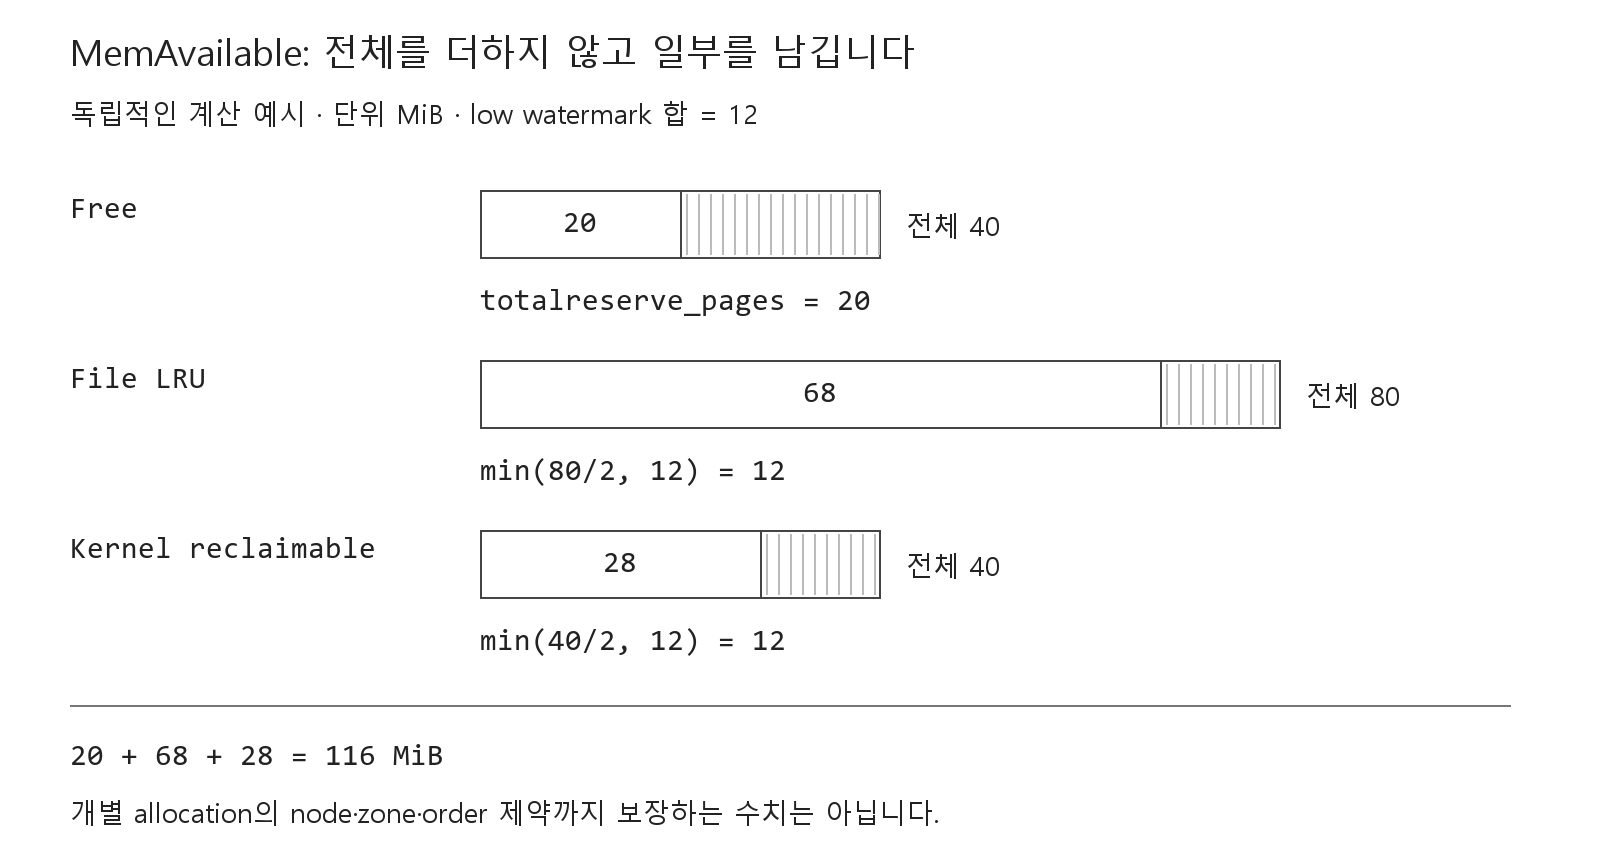
그림의 값에서는 free 40 MiB 중 20 MiB, file LRU 80 MiB 중 68 MiB, kernel reclaimable 40 MiB 중 28 MiB를 더해 116 MiB가 됩니다. 실제 함수는 page 단위 정수 연산으로 계산하므로, 임의의 byte 단위 실수 계산과 세부 반올림까지 같지는 않습니다.
실제 함수의 시작부터 반환까지 읽습니다
책의 Listing 14-4는 원본 두 쪽에 걸쳐 있습니다. 앞쪽의 선언과 뒷쪽의 계산을 연결해야 함수 전체가 됩니다. 책에서는 mm/page_alloc.c에 있던 구현을 다루지만, 여기서 확인한 Linux v6.12에서는 mm/show_mem.c에 있습니다.
아래는 Linux v6.12의 함수 전체입니다. Kernel 내부의 counter와 zone API를 사용하는 코드이므로 독립적인 userspace 프로그램으로 compile하는 예제가 아닙니다. 원본 파일의 GPL-2.0-only 표시와 출처를 함께 남겼습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Linux v6.12 mm/show_mem.c, complete si_mem_available() excerpt.
 * File copyright (C) 2008 Johannes Weiner <hannes@saeurebad.de>.
 * Source: https://github.com/torvalds/linux/blob/v6.12/mm/show_mem.c
 * Kernel context required; this is not a standalone userspace program.
 */
long si_mem_available(void)
{
	long available;
	unsigned long pagecache;
	unsigned long wmark_low = 0;
	unsigned long reclaimable;
	struct zone *zone;

	for_each_zone(zone)
		wmark_low += low_wmark_pages(zone);

	/*
	 * Estimate the amount of memory available for userspace allocations,
	 * without causing swapping or OOM.
	 */
	available = global_zone_page_state(NR_FREE_PAGES) - totalreserve_pages;

	/*
	 * Not all the page cache can be freed, otherwise the system will
	 * start swapping or thrashing. Assume at least half of the page
	 * cache, or the low watermark worth of cache, needs to stay.
	 */
	pagecache = global_node_page_state(NR_ACTIVE_FILE) +
		global_node_page_state(NR_INACTIVE_FILE);
	pagecache -= min(pagecache / 2, wmark_low);
	available += pagecache;

	/*
	 * Part of the reclaimable slab and other kernel memory consists of
	 * items that are in use, and cannot be freed. Cap this estimate at the
	 * low watermark.
	 */
	reclaimable = global_node_page_state_pages(NR_SLAB_RECLAIMABLE_B) +
		global_node_page_state(NR_KERNEL_MISC_RECLAIMABLE);
	reclaimable -= min(reclaimable / 2, wmark_low);
	available += reclaimable;

	if (available < 0)
		available = 0;
	return available;
}
이 구현은 file LRU의 두 counter를 직접 더합니다. 책의 고전 구현처럼 NR_LRU_LISTS 배열을 먼저 채우는 형태와 달라도, active·inactive file pages를 모아 reserve를 제외한다는 계산 관계는 같습니다. Slab 쪽에는 global_node_page_state_pages()를 사용하고, miscellaneous reclaimable counter와 함께 page 단위로 계산합니다.
meminfo_proc_show()는 이렇게 얻은 page 단위 값을 /proc/meminfo의 단위로 표시합니다. 함수가 반환한 long을 이미 byte 수나 KiB 값으로 읽으시면 안 됩니다. 이 함수의 원본 전체 파일, 함께 제공하는 GPL-2.0-only license와 공식 license 파일도 확인하실 수 있습니다.
높은 order의 allocation에는 다른 질문이 필요합니다
MemAvailable이 충분해도 연속된 physical memory가 부족할 수 있습니다. Buddy allocator에서 order n의 block은 2^n개의 연속된 base pages입니다. Base page가 4 KiB이면 order 5는 32 pages, 즉 128 KiB입니다.
Order 0 요청은 높은 order의 block을 나누어서도 만족시킬 수 있습니다. 반대로 order가 높은 요청은 같은 총량의 free pages가 흩어져 있다는 사실만으로 만족시킬 수 없습니다. 필요한 node, zone, GFP 조건과 fragmentation을 함께 살펴보아야 합니다. 높은 order의 실패가 반드시 OOM kill로 이어지는 것도 아닙니다.
/proc/buddyinfo는 node와 zone별로 각 order의 free block 개수를 보여 줍니다. 각 열은 byte 수나 page 수가 아니라 해당 order의 block 개수입니다. 따라서 전체 크기를 계산하려면 열 n의 값에 2^n과 base page 크기를 곱해야 합니다.
다음 역시 실제 측정이 아닌 독립적인 예시입니다. 숫자 열은 왼쪽부터 order 0, 1, 2, ... 순서입니다.
Node 0, zone Normal  4 2 1 0 0 0 0 0 0 0 0
Node 1, zone Normal  0 0 0 1 0 0 0 0 0 0 0
4 KiB base page를 가정하면 node 0에는 (4 + 2*2 + 1*4) * 4 = 48 KiB, node 1에는 1 * 8 * 4 = 32 KiB가 표시되어 있습니다. Node 0의 총량이 더 크지만 이 표에는 order 3 block이 없습니다. Node 1에는 order 3 block이 하나 있습니다. 요청의 NUMA policy와 zone 조건을 무시하고 두 행을 합한 총량만 보시면 이런 차이를 놓치게 됩니다. Buddy의 최대 order 명칭과 configuration도 kernel version에 따라 확인해야 하며, 책의 MAX_ORDER - 1 표기를 모든 version의 고정 상수로 사용하지 않습니다.
이 표 역시 allocation 성공 판정기는 아닙니다. CPU별 cache, 동시 allocation과 migration, 요청의 제약 때문에 조회 직후에도 상태가 달라질 수 있습니다. 전체적인 여유를 볼 때는 MemAvailable, 연속성 문제를 의심할 때는 buddyinfo를 출발점으로 삼고, 실제 실패한 allocation의 조건으로 범위를 좁히시는 편이 좋습니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access edition, 2025, §14.1.
- Linux v6.12
mm/show_mem.c,si_mem_available() - Linux v6.12
/procdocumentation - procps-ng v4.0.4
free.c