파일에서 8 KiB를 읽겠다고 요청했는데 read()가 4 KiB만 돌려주었다면 어디에서 멈춘 것일까요? EOF를 만났을 수도 있지만, file data는 준비되어 있는데 목적지 user buffer의 뒷부분에 복사하지 못했을 수도 있습니다. read 경로는 요청의 크기보다 실제로 전달한 byte 수를 기준으로 상태를 전진시킵니다.
이 글에서는 일반적인 buffered read를 upstream Linux v6.18과 대조해 설명합니다. 여기서 read()가 stdio buffering을 사용하지 않는다는 말은 page cache를 우회한다는 뜻이 아닙니다. fread()의 라이브러리 buffer와 kernel의 page cache는 서로 다른 층입니다.
다음은 반환값을 확인하며 EOF까지 읽은 byte 수를 세는 독립 예제입니다. 처음의 파일 크기만큼 반드시 읽힐 때까지 반복하지 않고, 매번 양수 반환을 진행량에 더하며 0이면 종료합니다. 파일이 중간에 줄어들어도 0-byte read를 무한 반복하지 않습니다. EINTR이면 재시도하고 그 밖의 read 오류는 별도로 보고합니다. binary data에 문자열 종단 문자를 덧붙이거나 파일 전체 크기의 buffer를 미리 할당할 필요도 없습니다.
#define _POSIX_C_SOURCE 200809L
#include <errno.h>
#include <fcntl.h>
#include <inttypes.h>
#include <stdio.h>
#include <unistd.h>

int main(int argc, char **argv)
{
    char buf[4096];
    uintmax_t total = 0;
    int fd;
    int result = 0;

    if (argc != 2) {
        fprintf(stderr, "usage: %s FILE\n", argv[0]);
        return 2;
    }
    fd = open(argv[1], O_RDONLY);
    if (fd < 0) { perror("open"); return 1; }
    for (;;) {
        ssize_t n = read(fd, buf, sizeof(buf));
        if (n < 0 && errno == EINTR) continue;
        if (n < 0) { perror("read"); result = 1; break; }
        if (n == 0) break;
        if ((uintmax_t)n > UINTMAX_MAX - total) {
            fputs("byte count overflow\n", stderr);
            result = 1;
            break;
        }
        total += (uintmax_t)n;
    }
    if (close(fd) < 0) { perror("close"); result = 1; }
    if (printf("bytes_read=%" PRIuMAX "\n", total) < 0) result = 1;
    return result;
}
이 예제는 파일을 변경하지 않지만, 다른 writer와 경쟁하는 파일의 일관된 snapshot을 보장하지는 않습니다. close() 실패 뒤 같은 fd 번호로 무조건 close를 반복하지도 않습니다. 반환값과 오류 계약은 read(2)에 근거합니다.
예제는 경고를 오류로 처리한 문법 검사를 통과했지만, 이 글에서 runtime 출력이나 성능 측정값을 제시하지는 않습니다.
file position을 보호해도 내용이 snapshot이 되지는 않습니다
ksys_read()는 fd에서 열린 file을 얻고 vfs_read()에 실제 작업을 맡깁니다. fdget_pos()와 fdput_pos()는 필요할 때 file 참조와 position 관련 직렬화를 다룹니다. 공유 open file description의 position을 여러 thread가 동시에 바꾸는 일과, 각각 다른 file을 별도로 열어 읽는 일은 구분해야 합니다.
v6.18 source에는 이 수명 정리가 CLASS(fd_pos, f)라는 scoped cleanup 형태로 나타납니다. 내부의 fdget_pos()와 fdput_pos() 계약이 사라진 것은 아닙니다. 열린 file을 못 찾으면 -EBADF이며, seek 가능한 file은 임시 position을 전달하고 성공한 read 뒤 실제 f_pos에 반영합니다. FMODE_ATOMIC_POS와 f_pos_lock의 조건부 직렬화를 모든 inode의 content lock이라고 생각해서는 안 됩니다. Linux 3.14 이전 공유 offset 문제가 수정된 사실과, 지금도 파일 내용 변경은 별도로 경쟁한다는 사실은 동시에 성립합니다. read 구현, fd cleanup 정의
position 직렬화는 같은 f_pos를 갱신하는 연산들이 서로 겹쳐 잘못 전진하는 문제를 다룹니다. 다른 writer의 파일 내용 변경이나 truncate까지 막는 lock은 아닙니다. 따라서 read의 시작 시점에 파일 길이를 한 번 확인했다고 끝까지 같은 데이터와 EOF를 보게 된다는 보장은 없습니다.
Linux의 공유 offset atomicity에는 과거 버전과의 차이도 있습니다. 오래된 kernel의 동작을 현재의 일반 regular-file read에 그대로 적용해서는 안 됩니다. user interface 수준의 반환값과 offset 계약은 read(2) 및 syscall 구현에서 확인할 수 있습니다.
동기 read도 iterator interface를 사용합니다
VFS는 filesystem이 제공한 read 또는 read_iter 구현으로 작업을 전달합니다. iterator 경로에서 new_sync_read()는 struct kiocb와 struct iov_iter를 준비합니다. kiocb는 열린 file, 현재 위치인 ki_pos, I/O flag와 priority 같은 호출 상태를 운반합니다. 동기 작업의 kiocb가 stack에 있다는 사실을 비동기 요청의 객체 수명과 혼동해서는 안 됩니다.
iov_iter는 단순히 user pointer를 다른 이름으로 쓴 객체가 아닙니다. 목적지와 남은 길이, 지금까지의 전진을 표현하는 공통 interface입니다. 같은 interface가 다른 종류의 buffer도 다룰 수 있지만 여기서는 user buffer를 읽기 결과로 채우는 경우에 집중합니다.
초기화되는 ki_filp는 열린 file이고 ki_flags는 file에 준비된 f_iocb_flags, ki_ioprio는 현재 task의 I/O priority에서 옵니다. ki_pos에는 전달받은 position을 넣습니다. iocb_flags()는 O_APPEND, O_DIRECT, O_DSYNC, __O_SYNC를 각각 IOCB flag로 변환합니다. 쓰기 관련 flag도 공통 객체에 존재한다는 뜻이지 read가 append 동작을 수행한다는 뜻은 아닙니다. user buffer를 결과로 채우는 v6.18 iterator 방향은 ITER_DEST입니다. 오래된 source의 READ 표기와 이름이 달라도 buffer가 data source로 바뀐 것은 아닙니다. 초기화와 flag 변환
이전 구현의 call_read_iter() wrapper는 filesystem이 등록한 callback을 호출했습니다. v6.18의 new_sync_read()는 같은 callback을 filp->f_op->read_iter()로 직접 호출합니다. 이 동기 경로에서 callback이 -EIOCBQUEUED를 반환하면 bug 검사에 걸립니다. 완료되지 않은 비동기 요청을 stack의 임시 kiocb에 남길 수 없기 때문입니다. callback이 갱신한 ki_pos는 유효한 ppos가 있을 때 되돌려 줍니다.
아래는 v6.18의 new_sync_read(), init_sync_kiocb(), iocb_flags() 전체 정의입니다. 마지막 함수는 open flag를 변환하며, 첫 함수는 이미 file에 준비된 flag를 초기화 helper를 통해 받는다는 차이도 보실 수 있습니다. 각 파일의 source·notice와 license 자료를 보존했습니다. kernel 내부 의존성이 있는 함수 발췌이며 이 파일들만으로 standalone build를 할 수 있거나 모든 config를 compile했다는 뜻은 아닙니다.
// SPDX-License-Identifier: GPL-2.0
/*
 *  linux/fs/read_write.c
 *
 *  Copyright (C) 1991, 1992  Linus Torvalds
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 fs/read_write.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/fs/read_write.c
 * Upstream lines: 481-496
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static ssize_t new_sync_read(struct file *filp, char __user *buf, size_t len, loff_t *ppos)
{
	struct kiocb kiocb;
	struct iov_iter iter;
	ssize_t ret;

	init_sync_kiocb(&kiocb, filp);
	kiocb.ki_pos = (ppos ? *ppos : 0);
	iov_iter_ubuf(&iter, ITER_DEST, buf, len);

	ret = filp->f_op->read_iter(&kiocb, &iter);
	BUG_ON(ret == -EIOCBQUEUED);
	if (ppos)
		*ppos = kiocb.ki_pos;
	return ret;
}
/* SPDX-License-Identifier: GPL-2.0 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 include/linux/fs.h.
 * Source: https://github.com/torvalds/linux/blob/v6.18/include/linux/fs.h
 * Upstream lines: 2591-2598
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static inline void init_sync_kiocb(struct kiocb *kiocb, struct file *filp)
{
	*kiocb = (struct kiocb) {
		.ki_filp = filp,
		.ki_flags = filp->f_iocb_flags,
		.ki_ioprio = get_current_ioprio(),
	};
}
/* SPDX-License-Identifier: GPL-2.0 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 include/linux/fs.h.
 * Source: https://github.com/torvalds/linux/blob/v6.18/include/linux/fs.h
 * Upstream lines: 3815-3827
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static inline int iocb_flags(struct file *file)
{
	int res = 0;
	if (file->f_flags & O_APPEND)
		res |= IOCB_APPEND;
	if (file->f_flags & O_DIRECT)
		res |= IOCB_DIRECT;
	if (file->f_flags & O_DSYNC)
		res |= IOCB_DSYNC;
	if (file->f_flags & __O_SYNC)
		res |= IOCB_SYNC;
	return res;
}
비교할 과거 wrapper는 공식 v6.0의 전체 정의를 별도로 둡니다. v6.0이 책의 정확한 tag라는 주장은 아니며, 이 wrapper를 위 v6.18 호출에 끼워 넣어서도 안 됩니다.
/* SPDX-License-Identifier: GPL-2.0 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.0 include/linux/fs.h.
 * Source: https://github.com/torvalds/linux/blob/v6.0/include/linux/fs.h
 * Upstream lines: 2178-2182
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static inline ssize_t call_read_iter(struct file *file, struct kiocb *kio,
				     struct iov_iter *iter)
{
	return file->f_op->read_iter(kio, iter);
}
ext4는 forced shutdown이면 -EIO, 빈 iterator이면 atime 처리 없이 0을 반환하고, DAX·direct I/O 분기를 거른 buffered 경로에서 generic helper를 사용합니다. 다음은 v6.18의 구현코드가 아닌 호출관계이며 모든 filesystem에 강제되는 단일 stack은 아닙니다. ext4의 전체 callback
ksys_read()
  vfs_read()
    new_sync_read()
      file->f_op->read_iter()
        filesystem callback
          generic_file_read_iter()
            filemap_read()
빈 iterator는 곧바로 끝낼 수 있습니다. helper 여러 층에서 길이를 검사하는 것은 각각의 진입점이 직접 호출될 수도 있기 때문입니다. 어느 검사 하나가 있다는 이유로 하위 helper의 사전조건이 없어지는 것은 아닙니다.
실제 v6.18 callback과 generic helper는 다음과 같습니다. CONFIG_FS_DAX와 direct I/O 분기를 남겼으므로 buffered 경로만 읽으실 때에도 다른 진입 조건을 확인하실 수 있습니다. ext4는 별도의 direct-I/O helper로 빠지고, generic helper의 direct-I/O 경로는 일부 결과를 처리한 뒤 조건에 따라 나머지를 buffered read로 넘길 수 있습니다. DAX나 -EIOCBQUEUED까지 무조건 buffered fallback으로 이어지는 것은 아닙니다.
// SPDX-License-Identifier: GPL-2.0
/*
 *  linux/fs/ext4/file.c
 *
 * Copyright (C) 1992, 1993, 1994, 1995
 * Remy Card (card@masi.ibp.fr)
 * Laboratoire MASI - Institut Blaise Pascal
 * Universite Pierre et Marie Curie (Paris VI)
 *
 *  from
 *
 *  linux/fs/minix/file.c
 *
 *  Copyright (C) 1991, 1992  Linus Torvalds
 *
 *  ext4 fs regular file handling primitives
 *
 *  64-bit file support on 64-bit platforms by Jakub Jelinek
 *	(jj@sunsite.ms.mff.cuni.cz)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 fs/ext4/file.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/fs/ext4/file.c
 * Upstream lines: 130-148
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static ssize_t ext4_file_read_iter(struct kiocb *iocb, struct iov_iter *to)
{
	struct inode *inode = file_inode(iocb->ki_filp);

	if (unlikely(ext4_forced_shutdown(inode->i_sb)))
		return -EIO;

	if (!iov_iter_count(to))
		return 0; /* skip atime */

#ifdef CONFIG_FS_DAX
	if (IS_DAX(inode))
		return ext4_dax_read_iter(iocb, to);
#endif
	if (iocb->ki_flags & IOCB_DIRECT)
		return ext4_dio_read_iter(iocb, to);

	return generic_file_read_iter(iocb, to);
}
generic_file_read_iter_v6_18.c
// SPDX-License-Identifier: GPL-2.0-only
/*
 *	linux/mm/filemap.c
 *
 * Copyright (C) 1994-1999  Linus Torvalds
 */
/*
 * This file handles the generic file mmap semantics used by
 * most "normal" filesystems (but you don't /have/ to use this:
 * the NFS filesystem used to do this differently, for example)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Upstream lines: 2898-2941
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

ssize_t
generic_file_read_iter(struct kiocb *iocb, struct iov_iter *iter)
{
	size_t count = iov_iter_count(iter);
	ssize_t retval = 0;

	if (!count)
		return 0; /* skip atime */

	if (iocb->ki_flags & IOCB_DIRECT) {
		struct file *file = iocb->ki_filp;
		struct address_space *mapping = file->f_mapping;
		struct inode *inode = mapping->host;

		retval = kiocb_write_and_wait(iocb, count);
		if (retval < 0)
			return retval;
		file_accessed(file);

		retval = mapping->a_ops->direct_IO(iocb, iter);
		if (retval >= 0) {
			iocb->ki_pos += retval;
			count -= retval;
		}
		if (retval != -EIOCBQUEUED)
			iov_iter_revert(iter, count - iov_iter_count(iter));

		/*
		 * Btrfs can have a short DIO read if we encounter
		 * compressed extents, so if there was an error, or if
		 * we've already read everything we wanted to, or if
		 * there was a short read because we hit EOF, go ahead
		 * and return.  Otherwise fallthrough to buffered io for
		 * the rest of the read.  Buffered reads will not work for
		 * DAX files, so don't bother trying.
		 */
		if (retval < 0 || !count || IS_DAX(inode))
			return retval;
		if (iocb->ki_pos >= i_size_read(inode))
			return retval;
	}

	return filemap_read(iocb, iter, retval);
}
batch를 얻은 뒤 EOF를 다시 읽습니다
filemap_read()는 position과 filesystem의 최대 파일 크기, iterator 길이를 검사하고 읽을 범위를 제한합니다. 큰 파일을 지원한다고 이 최대값을 고정 숫자로 가정해서는 안 됩니다. filesystem과 그 구현 조건에 따라 달라집니다.
v6.18에서는 음수 position이 -EINVAL, s_maxbytes 이상인 position이나 빈 iterator가 0 반환 조건입니다. iterator를 제한하는 길이는 s_maxbytes 전체가 아니라 s_maxbytes - ki_pos입니다. 최대 파일 크기와 지금의 시작점에서 남은 길이는 다릅니다. 정상 EOF인 i_size 검사는 이 최대 주소 한도와 별도로 수행합니다.
그다음 folio_batch를 초기화하고 반복해서 filemap_get_pages()를 호출합니다. batch는 실제 folio pointer와 그에 대한 참조를 담습니다. folio가 여러 base page를 포함할 수도 있으므로 batch의 entry 수와 byte 수는 일치하지 않습니다. batch의 최대 용량도 자료구조의 구현 상수이지 read syscall의 최대 길이가 아닙니다.
batch를 얻으려는 동안에는 allocation, folio lock, I/O 같은 이유로 잠들 수 있습니다. 그 사이 다른 thread가 파일을 줄일 수 있습니다. 그래서 copy 전에 i_size를 다시 읽고, 현재 position이 새 EOF 밖이면 얻어 둔 folio의 참조를 정리한 뒤 멈춥니다. lookup에 성공했다는 사실만으로 옛 범위를 계속 복사하지 않습니다.
실제 종료 위치는 새 EOF와 ki_pos + 남은 요청량 중 작은 값입니다. 이 제한은 file byte 범위입니다. readahead가 그보다 먼 데이터를 준비할 수 있다는 사실이 user buffer에 EOF 너머까지 복사해도 된다는 허가는 아닙니다.
반복 사이에는 cond_resched() 같은 자발적 양보 지점도 있습니다. 특히 full preemption이 없는 구성에서 긴 read가 CPU를 계속 독점하지 않도록 하는 장치입니다. I/O 때문에 잠드는 것과 scheduler에 실행 기회를 주는 것은 다른 이유의 실행 중단입니다.
folio 안의 offset으로 복사량을 계산합니다
folio 하나를 처리할 때에는 folio_size()로 전체 크기를 얻고 ki_pos가 그 안의 어느 byte인지 계산합니다. 이번 copy의 byte 수는 folio 끝까지 남은 양과 전체 read의 종료 위치까지 남은 양 중 작은 값입니다. large folio라고 그 전체를 항상 복사하는 것은 아닙니다.
copy_folio_to_iter()가 복사한 양만큼 iterator와 ki_pos가 전진합니다. folio의 file 시작 위치가 이미 종료 범위 뒤라면 더 진행하지 않습니다. 이렇게 file 범위, folio 내부 범위와 user buffer 범위를 겹쳐 실제 copy 범위를 정합니다.
목적지에 접근할 수 없는 부분이 있으면 copy가 요청량보다 작을 수 있습니다. filemap_read()는 이때 오류를 기록하더라도 앞서 복사한 byte가 있으면 그 양을 반환합니다. 0 byte도 전달하지 못한 오류와 이미 일부를 전달한 short read는 user에게 다른 결과입니다.
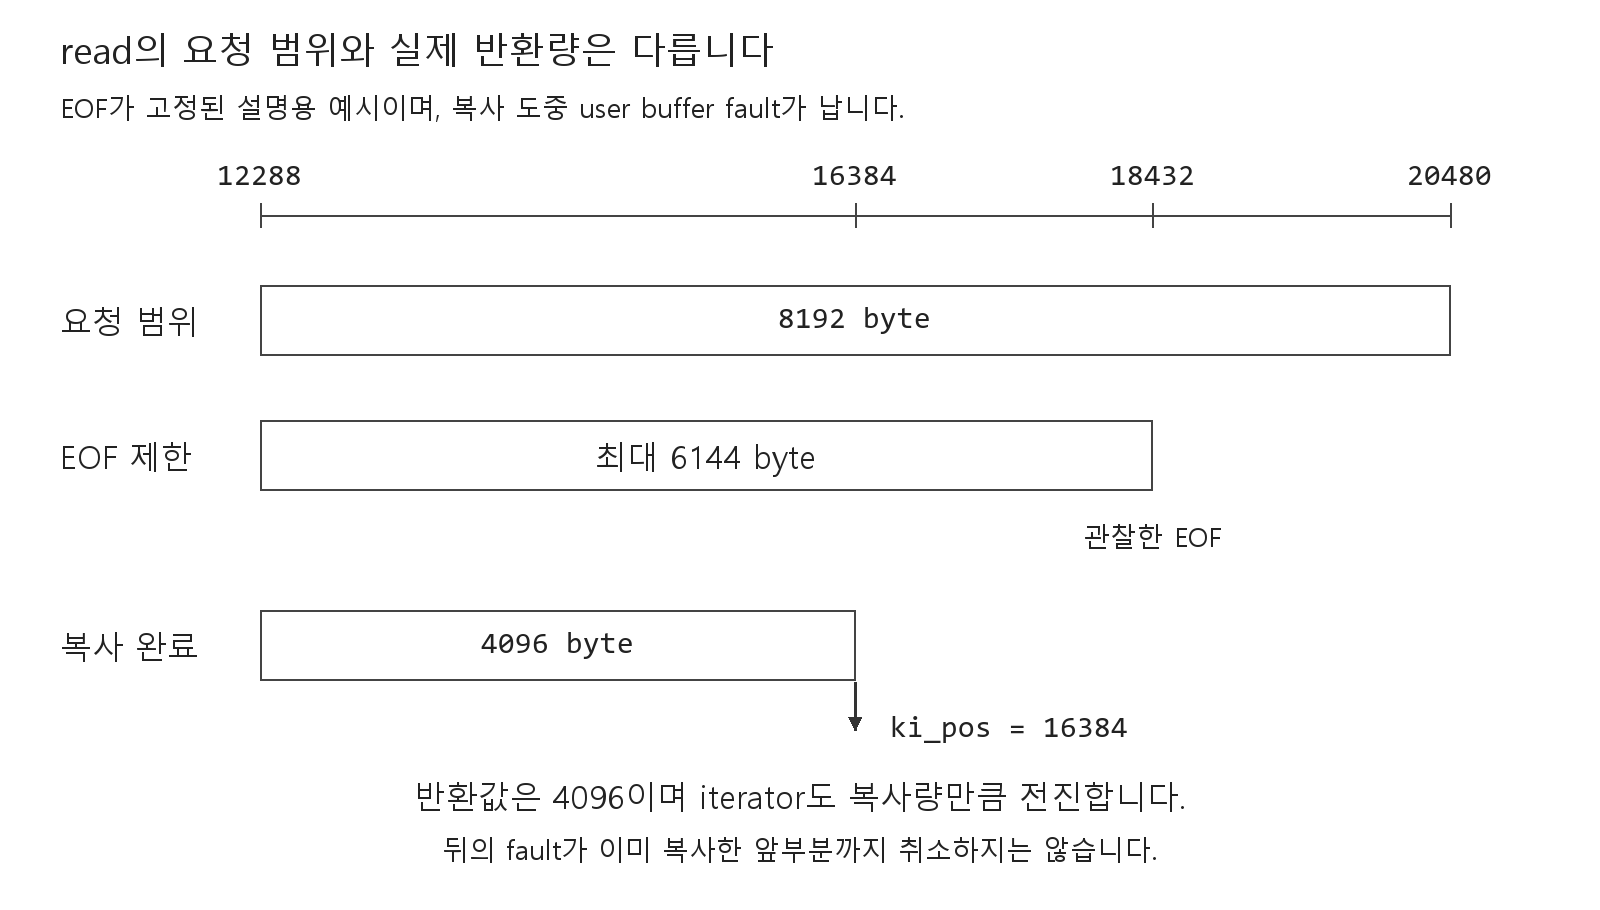
예시처럼 뒤의 접근이 실패했다고 앞부분의 copy를 rollback하지 않습니다. application은 양수 반환을 요청 전체의 성공으로 오해하지 않고 남은 양을 처리해야 합니다. 다음 read를 무조건 원래 시작 위치부터 반복하면 이미 전달한 데이터를 중복 처리할 수도 있습니다. 반대로 모든 short read를 곧바로 EOF로 취급해서도 안 됩니다.
accessed 표시는 byte counter가 아닙니다
읽은 folio는 reclaim에 최근 사용 사실을 전달해야 합니다. 그러나 같은 folio의 작은 조각을 나누어 읽을 때마다 독립적인 새 수요처럼 강조하는 것도 바람직하지 않습니다. f_ra.prev_pos와 pos_same_folio()가 첫 folio의 accessed 처리에 참여하는 이유입니다.
pos_same_folio()는 byte 위치를 folio 크기에 맞게 shift한 값으로 비교합니다. base page 하나로 고정해서 비교하면 large folio 내부에서 시작과 끝을 잘못 나눌 수 있습니다. 첫 folio 이후의 folio들은 별도로 accessed 처리합니다.
이 정책은 읽은 byte 수를 정확히 세려는 accounting이 아니라 reclaim 우선순위에 접근의 의미를 전달하려는 것입니다. f_ra가 readahead 상태를 담는다는 사실도 이 field를 disk read 완료량으로 해석해도 된다는 뜻은 아닙니다.
경계 비교에는 이전 exclusive position에서 1을 뺀 byte를 사용합니다. 이전 read가 정확히 folio 끝에서 끝났다면 그 byte는 이전 folio에 속하고, 새 read의 첫 byte는 다음 folio에 속하기 때문입니다. v6.18은 이전 위치를 local last_pos로 가져와 copy 뒤 갱신하고 함수 말미에 ra->prev_pos로 저장합니다. 오래된 구현처럼 매 copy 직후 공유 field를 직접 갱신하는 것으로 읽어서는 안 됩니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *	linux/mm/filemap.c
 *
 * Copyright (C) 1994-1999  Linus Torvalds
 */
/*
 * This file handles the generic file mmap semantics used by
 * most "normal" filesystems (but you don't /have/ to use this:
 * the NFS filesystem used to do this differently, for example)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Upstream lines: 2679-2684
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

static inline bool pos_same_folio(loff_t pos1, loff_t pos2, struct folio *folio)
{
	unsigned int shift = folio_shift(folio);

	return (pos1 >> shift == pos2 >> shift);
}
참조와 atime까지 정리하고 돌아갑니다
batch에서 얻은 folio 참조는 성공과 오류 경로 모두에서 정리해야 합니다. copy loop를 빠져나온 뒤 모든 batch entry에 대한 참조를 놓고 batch를 초기화해야 다음 반복에서 같은 참조를 중복 해제하거나 잃어버리지 않습니다. iterator가 비었거나 EOF에 도달했거나 오류가 생기면 바깥 반복도 종료합니다.
마지막의 file_accessed()는 파일 접근 시간 처리로 이어집니다. 그렇다고 read syscall 하나마다 inode를 disk에 써야 하는 것은 아닙니다. relatime, noatime 등의 mount 정책과 timestamp 조건이 적용됩니다. data folio의 accessed 표시는 reclaim의 판단이고 atime은 filesystem metadata의 정책이라는 구별도 필요합니다.
relatime에서는 mtime이나 ctime이 atime보다 새롭거나 같은 경우, 또는 마지막 atime에서 하루 이상 지난 경우 등을 검사합니다. 이 조건과 mount의 atime 허용 여부를 먼저 통과해야 하므로 read 횟수와 metadata write 횟수는 일치하지 않습니다. 전체 zero-length read가 상위 helper에서 반환되면 이 말미까지 내려오지 않을 수도 있습니다. atime 조건
현재 구현의 구체적인 copy, position 전진과 반환 선택은 filemap_read()의 전체 정의에서 함께 읽을 수 있습니다. 한 줄의 반환식보다 중요한 것은 그 반환값에 이르기까지 copy량, EOF와 folio 참조를 일관되게 맞추었다는 점입니다.
여기서는 그 전체 정의도 직접 수록합니다. IOCB_WAITQ에서 진행량이 생긴 뒤 IOCB_NOWAIT를 붙이는 조건, 모든 batch 참조를 놓는 put_folios, dropbehind 정리와 최종 반환까지 생략하지 않았습니다. 앞서 계산한 범위가 뒤의 EOF 재확인·copy 실패와 어떻게 만나는지 처음부터 끝까지 따라가실 수 있습니다. 이 source 대조는 runtime 관찰이나 책과의 commit 일치 검증을 대신하지 않습니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 *	linux/mm/filemap.c
 *
 * Copyright (C) 1994-1999  Linus Torvalds
 */
/*
 * This file handles the generic file mmap semantics used by
 * most "normal" filesystems (but you don't /have/ to use this:
 * the NFS filesystem used to do this differently, for example)
 */

/*
 * Exact named definitions / explicit macro groups from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * Upstream lines: 2711-2823
 * See LICENSES and UPSTREAM-NOTICES.md; kernel excerpt, not a translation unit.
 * This tag is not asserted to be the book's exact revision.
 */

ssize_t filemap_read(struct kiocb *iocb, struct iov_iter *iter,
		ssize_t already_read)
{
	struct file *filp = iocb->ki_filp;
	struct file_ra_state *ra = &filp->f_ra;
	struct address_space *mapping = filp->f_mapping;
	struct inode *inode = mapping->host;
	struct folio_batch fbatch;
	int i, error = 0;
	bool writably_mapped;
	loff_t isize, end_offset;
	loff_t last_pos = ra->prev_pos;

	if (unlikely(iocb->ki_pos < 0))
		return -EINVAL;
	if (unlikely(iocb->ki_pos >= inode->i_sb->s_maxbytes))
		return 0;
	if (unlikely(!iov_iter_count(iter)))
		return 0;

	iov_iter_truncate(iter, inode->i_sb->s_maxbytes - iocb->ki_pos);
	folio_batch_init(&fbatch);

	do {
		cond_resched();

		/*
		 * If we've already successfully copied some data, then we
		 * can no longer safely return -EIOCBQUEUED. Hence mark
		 * an async read NOWAIT at that point.
		 */
		if ((iocb->ki_flags & IOCB_WAITQ) && already_read)
			iocb->ki_flags |= IOCB_NOWAIT;

		if (unlikely(iocb->ki_pos >= i_size_read(inode)))
			break;

		error = filemap_get_pages(iocb, iter->count, &fbatch, false);
		if (error < 0)
			break;

		/*
		 * i_size must be checked after we know the pages are Uptodate.
		 *
		 * Checking i_size after the check allows us to calculate
		 * the correct value for "nr", which means the zero-filled
		 * part of the page is not copied back to userspace (unless
		 * another truncate extends the file - this is desired though).
		 */
		isize = i_size_read(inode);
		if (unlikely(iocb->ki_pos >= isize))
			goto put_folios;
		end_offset = min_t(loff_t, isize, iocb->ki_pos + iter->count);

		/*
		 * Once we start copying data, we don't want to be touching any
		 * cachelines that might be contended:
		 */
		writably_mapped = mapping_writably_mapped(mapping);

		/*
		 * When a read accesses the same folio several times, only
		 * mark it as accessed the first time.
		 */
		if (!pos_same_folio(iocb->ki_pos, last_pos - 1,
				    fbatch.folios[0]))
			folio_mark_accessed(fbatch.folios[0]);

		for (i = 0; i < folio_batch_count(&fbatch); i++) {
			struct folio *folio = fbatch.folios[i];
			size_t fsize = folio_size(folio);
			size_t offset = iocb->ki_pos & (fsize - 1);
			size_t bytes = min_t(loff_t, end_offset - iocb->ki_pos,
					     fsize - offset);
			size_t copied;

			if (end_offset < folio_pos(folio))
				break;
			if (i > 0)
				folio_mark_accessed(folio);
			/*
			 * If users can be writing to this folio using arbitrary
			 * virtual addresses, take care of potential aliasing
			 * before reading the folio on the kernel side.
			 */
			if (writably_mapped)
				flush_dcache_folio(folio);

			copied = copy_folio_to_iter(folio, offset, bytes, iter);

			already_read += copied;
			iocb->ki_pos += copied;
			last_pos = iocb->ki_pos;

			if (copied < bytes) {
				error = -EFAULT;
				break;
			}
		}
put_folios:
		for (i = 0; i < folio_batch_count(&fbatch); i++) {
			struct folio *folio = fbatch.folios[i];

			filemap_end_dropbehind_read(folio);
			folio_put(folio);
		}
		folio_batch_init(&fbatch);
	} while (iov_iter_count(iter) && iocb->ki_pos < isize && !error);

	file_accessed(filp);
	ra->prev_pos = last_pos;
	return already_read ? already_read : error;
}
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 9, §9.3.
- Linux v6.18: read_write.c, fs.h, filemap.c.
- read(2).