anonymous folio의 index를 현재 virtual address를 PAGE_SHIFT만큼 내린 값이라고 외우면 mremap()에서 막힙니다. VMA를 다른 곳으로 옮겨도 모든 folio index를 바꾸지 않기 때문입니다. index는 현재 주소 그 자체가 아니라 VMA가 보관한 논리 offset 좌표로 해석해야 합니다.
주소를 논리 page index로 바꿉니다
base-page 관계는 index = vm_pgoff + (address - vm_start) / PAGE_SIZE입니다. 반대 변환은 address = vm_start + (index - vm_pgoff) * PAGE_SIZE입니다. 이는 kernel 구현 code가 아니라 같은 backing을 다른 VA에서 표현하는 좌표 관계입니다. file mapping의 vm_pgoff는 file page offset이고 anonymous도 논리 기준점을 가집니다.
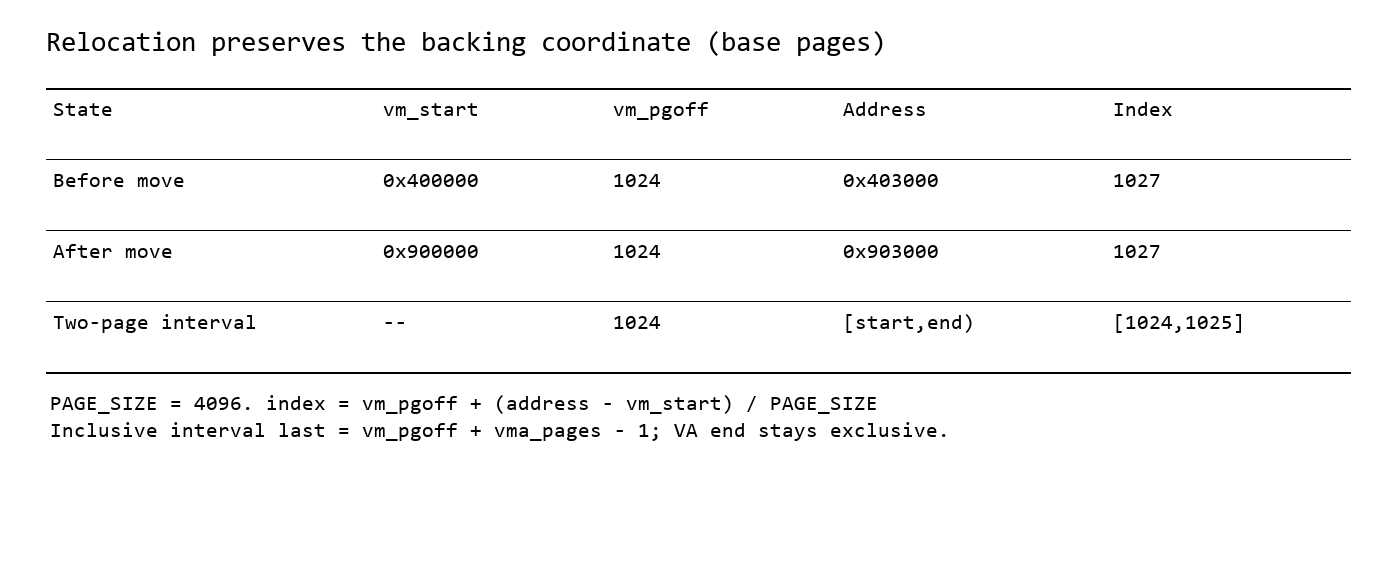
새 mapping과 기존 mapping 추가
새 anonymous folio를 등록할 때에는 swap-backed 상태, mapping tag, index와 최초 mapcount를 초기화합니다. 이미 mapping된 folio에 PTE를 더할 때에는 mapcount를 증가시키고 첫 mapping 전환에 필요한 통계만 갱신합니다. huge folio의 PTE·PMD mapping은 별도 counting 규칙이 있어 order-0 숫자를 그대로 사용하지 않습니다.
order-0 raw _mapcount는 unmapped가 -1, 첫 mapping이 0인 표현입니다. helper가 반환하는 논리 개수와 raw 저장값을 구별해야 합니다. rmap 추가·제거는 mapping 수를 추적하지만 object reference를 전부 나타내지는 않습니다. page cache나 pin이 남으면 논리 mapping count가 0, 즉 이 표현의 raw 값이 -1이어도 folio는 살아 있을 수 있습니다.
mapping pointer에는 종류 tag가 있습니다
anonymous folio의 mapping은 tagged anon_vma pointer입니다. shared로 복원하는 folio는 root ancestry를 사용할 수 있고, exclusive 재사용에서는 현재 VMA의 active anon_vma로 옮길 수 있습니다. mapping tag를 빼지 않고 address_space pointer처럼 dereference하면 안 됩니다. KSM과 movable 관련 tag도 구별해야 합니다.
file folio는 address_space가 backing identity를 제공하므로 rmap 추가는 file mapcount와 accounting을 중심으로 합니다. file VMA가 CoW한 folio는 anonymous일 수 있어 VMA 분류와 folio 분류가 항상 같지는 않습니다. truncate가 private copy까지 무효화하는지는 실제 unmap 범위와 even_cows 조건을 함께 보아야 합니다.
마지막 mapping 제거와 마지막 object 해제
rmap 제거는 마지막 mapping 전환에서 통계와 mlock 상태를 정리할 수 있지만 mapping pointer를 즉시 NULL로 만드는 것과 같지 않습니다. 다른 rmap 추가와 경쟁할 수 있고 최종 free 준비에서의 metadata reset은 또 다른 단계입니다.
VMA의 anonymous 연결 종료는 root lock 아래 AVC를 tree에서 제거하고 child·active count를 조정합니다. 최종 put_anon_vma()는 같은 root lock이 필요할 수 있어 lock을 놓은 뒤 수행하도록 구분합니다. root가 child 때문에 살아 있는 관계도 reference로 유지해야 합니다.
RCU는 pointer를 관찰할 때의 수명 protocol에 참여하지만 tree write lock을 대신하지 않습니다. SLAB_TYPESAFE_BY_RCU 환경에서 같은 주소가 같은 객체라고 가정할 수 없으며, mapped 상태와 reference 획득 뒤의 재확인이 필요합니다. rmap은 pointer 하나보다 많은 종류의 수명을 겹쳐 다루는 기능입니다.
새 page와 기존 page의 rmap 추가를 비교합니다
이하 코드는 official Linux v6.0의 전체 function 정의입니다. 책의 exact source tag가 전역적으로 확정됐다는 뜻은 아니며, v6.18의 folio API로 조용히 대체하지 않았습니다. 특히 historical raw mapcount와 compound page counting을 다른 version의 field에 그대로 대응시키지 않겠습니다. Kernel context source로서 별도 build·runtime 실행은 하지 않았습니다. 원래 copyright notice와 COPYING, GPL-2.0를 보존했습니다.
page_add_new_anon_rmap()은 새 page라는 계약을 이용해 count를 직접 초기화합니다. 이미 사용 중인 page에 이 함수를 쓰면 기존 mapping 수를 지워 버릴 수 있으므로, 이름의 new는 최적화 설명만이 아니라 호출 조건입니다. 기존 page의 추가 경로는 increment-and-test를 사용하고, first transition에서만 mapped 통계를 올립니다. PTE lock과 page lock, KSM 분기의 별도 memcg 처리를 함께 읽으셔야 합니다.
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1262-1283
 * Exact source lines, not a restored book listing or standalone program.
 */
void page_add_new_anon_rmap(struct page *page,
	struct vm_area_struct *vma, unsigned long address)
{
	const bool compound = PageCompound(page);
	int nr = compound ? thp_nr_pages(page) : 1;

	VM_BUG_ON_VMA(address < vma->vm_start || address >= vma->vm_end, vma);
	__SetPageSwapBacked(page);
	if (compound) {
		VM_BUG_ON_PAGE(!PageTransHuge(page), page);
		/* increment count (starts at -1) */
		atomic_set(compound_mapcount_ptr(page), 0);
		atomic_set(compound_pincount_ptr(page), 0);

		__mod_lruvec_page_state(page, NR_ANON_THPS, nr);
	} else {
		/* increment count (starts at -1) */
		atomic_set(&page->_mapcount, 0);
	}
	__mod_lruvec_page_state(page, NR_ANON_MAPPED, nr);
	__page_set_anon_rmap(page, vma, address, 1);
}
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1200-1247
 * Exact source lines, not a restored book listing or standalone program.
 */
void page_add_anon_rmap(struct page *page,
	struct vm_area_struct *vma, unsigned long address, rmap_t flags)
{
	bool compound = flags & RMAP_COMPOUND;
	bool first;

	if (unlikely(PageKsm(page)))
		lock_page_memcg(page);
	else
		VM_BUG_ON_PAGE(!PageLocked(page), page);

	if (compound) {
		atomic_t *mapcount;
		VM_BUG_ON_PAGE(!PageLocked(page), page);
		VM_BUG_ON_PAGE(!PageTransHuge(page), page);
		mapcount = compound_mapcount_ptr(page);
		first = atomic_inc_and_test(mapcount);
	} else {
		first = atomic_inc_and_test(&page->_mapcount);
	}
	VM_BUG_ON_PAGE(!first && (flags & RMAP_EXCLUSIVE), page);
	VM_BUG_ON_PAGE(!first && PageAnonExclusive(page), page);

	if (first) {
		int nr = compound ? thp_nr_pages(page) : 1;
		/*
		 * We use the irq-unsafe __{inc|mod}_zone_page_stat because
		 * these counters are not modified in interrupt context, and
		 * pte lock(a spinlock) is held, which implies preemption
		 * disabled.
		 */
		if (compound)
			__mod_lruvec_page_state(page, NR_ANON_THPS, nr);
		__mod_lruvec_page_state(page, NR_ANON_MAPPED, nr);
	}

	if (unlikely(PageKsm(page)))
		unlock_page_memcg(page);

	/* address might be in next vma when migration races vma_adjust */
	else if (first)
		__page_set_anon_rmap(page, vma, address,
				     !!(flags & RMAP_EXCLUSIVE));
	else
		__page_check_anon_rmap(page, vma, address);

	mlock_vma_page(page, vma, compound);
}
RMAP_EXCLUSIVE는 단순히 mapcount가 작다는 뜻으로 만들 수 있는 소유권 보장이 아닙니다. 아래 helper는 이미 PageAnon()인 page라면 mapping과 index 초기화를 건너뜁니다. 따라서 non-exclusive 경로가 호출될 때마다 무조건 pointer를 root로 덮어쓴다고 해석하면 안 됩니다. 초기 연결에 필요한 경우에 root를 고르고, pointer와 anonymous tag를 한 번의 WRITE_ONCE()로 저장합니다.
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1129-1159
 * Exact source lines, not a restored book listing or standalone program.
 */
static void __page_set_anon_rmap(struct page *page,
	struct vm_area_struct *vma, unsigned long address, int exclusive)
{
	struct anon_vma *anon_vma = vma->anon_vma;

	BUG_ON(!anon_vma);

	if (PageAnon(page))
		goto out;

	/*
	 * If the page isn't exclusively mapped into this vma,
	 * we must use the _oldest_ possible anon_vma for the
	 * page mapping!
	 */
	if (!exclusive)
		anon_vma = anon_vma->root;

	/*
	 * page_idle does a lockless/optimistic rmap scan on page->mapping.
	 * Make sure the compiler doesn't split the stores of anon_vma and
	 * the PAGE_MAPPING_ANON type identifier, otherwise the rmap code
	 * could mistake the mapping for a struct address_space and crash.
	 */
	anon_vma = (void *) anon_vma + PAGE_MAPPING_ANON;
	WRITE_ONCE(page->mapping, (struct address_space *) anon_vma);
	page->index = linear_page_index(vma, address);
out:
	if (exclusive)
		SetPageAnonExclusive(page);
}
좌표 변환의 address - vm_start가 필요한 이유도 코드에 드러납니다. mremap() 뒤의 현재 VA를 그대로 shift하는 것이 아니라 보존된 vm_pgoff와 결합합니다. HugeTLB 전용 경로도 함수 안에서 생략하지 않았습니다.
/* SPDX-License-Identifier: GPL-2.0 */

/* Upstream Linux v6.0: include/linux/pagemap.h:845-854
 * Exact source lines, not a restored book listing or standalone program.
 */
static inline pgoff_t linear_page_index(struct vm_area_struct *vma,
					unsigned long address)
{
	pgoff_t pgoff;
	if (unlikely(is_vm_hugetlb_page(vma)))
		return linear_hugepage_index(vma, address);
	pgoff = (address - vma->vm_start) >> PAGE_SHIFT;
	pgoff += vma->vm_pgoff;
	return pgoff;
}
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1102-1120
 * Exact source lines, not a restored book listing or standalone program.
 */
void page_move_anon_rmap(struct page *page, struct vm_area_struct *vma)
{
	struct anon_vma *anon_vma = vma->anon_vma;
	struct page *subpage = page;

	page = compound_head(page);

	VM_BUG_ON_PAGE(!PageLocked(page), page);
	VM_BUG_ON_VMA(!anon_vma, vma);

	anon_vma = (void *) anon_vma + PAGE_MAPPING_ANON;
	/*
	 * Ensure that anon_vma and the PAGE_MAPPING_ANON bit are written
	 * simultaneously, so a concurrent reader (eg folio_referenced()'s
	 * folio_test_anon()) will not see one without the other.
	 */
	WRITE_ONCE(page->mapping, (struct address_space *) anon_vma);
	SetPageAnonExclusive(subpage);
}
Exclusive 재사용의 move는 page 내용을 복사하는 함수가 아닙니다. Compound head에 mapping을 저장하되 exclusive flag는 해당 subpage에 설정하는 구분도 남아 있습니다. 이 동작이 안전한지는 caller가 확보한 소유권과 page lock 계약으로 판단해야 합니다.
마지막 PTE 제거가 folio free를 뜻하지는 않습니다
다음 함수는 anonymous, file, compound 경로를 구분하고, 마지막 raw mapcount 전환에서 통계를 줄입니다. mapping pointer를 즉시 지우지 않는 주석은 중요합니다. 다른 add 경로가 이미 증가시킨 count와 먼저 설치한 mapping을 뒤늦은 reset이 망가뜨릴 수 있기 때문입니다. 최종 allocator free 단계와 rmap 제거를 분리하셔야 합니다.
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1429-1471
 * Exact source lines, not a restored book listing or standalone program.
 */
void page_remove_rmap(struct page *page,
	struct vm_area_struct *vma, bool compound)
{
	lock_page_memcg(page);

	if (!PageAnon(page)) {
		page_remove_file_rmap(page, compound);
		goto out;
	}

	if (compound) {
		page_remove_anon_compound_rmap(page);
		goto out;
	}

	/* page still mapped by someone else? */
	if (!atomic_add_negative(-1, &page->_mapcount))
		goto out;

	/*
	 * We use the irq-unsafe __{inc|mod}_zone_page_stat because
	 * these counters are not modified in interrupt context, and
	 * pte lock(a spinlock) is held, which implies preemption disabled.
	 */
	__dec_lruvec_page_state(page, NR_ANON_MAPPED);

	if (PageTransCompound(page))
		deferred_split_huge_page(compound_head(page));

	/*
	 * It would be tidy to reset the PageAnon mapping here,
	 * but that might overwrite a racing page_add_anon_rmap
	 * which increments mapcount after us but sets mapping
	 * before us: so leave the reset to free_unref_page,
	 * and remember that it's only reliable while mapped.
	 * Leaving it set also helps swapoff to reinstate ptes
	 * faster for those pages still in swapcache.
	 */
out:
	unlock_page_memcg(page);

	munlock_vma_page(page, vma, compound);
}
File rmap의 count도 "서로 다른 VMA 객체의 개수"라고 단순화하지 않습니다. 실제 PTE·PMD mapping과 subpage의 accounting을 처리하는 코드입니다. 원본 지면에서 생략됐던 compound·HugeTLB·DoubleMap 분기도 아래 official source에는 그대로 남겼습니다. Order-0 설명을 그 모든 분기에 그대로 적용했다는 뜻은 아닙니다.
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1293-1340
 * Exact source lines, not a restored book listing or standalone program.
 */
void page_add_file_rmap(struct page *page,
	struct vm_area_struct *vma, bool compound)
{
	int i, nr = 0;

	VM_BUG_ON_PAGE(compound && !PageTransHuge(page), page);
	lock_page_memcg(page);
	if (compound && PageTransHuge(page)) {
		int nr_pages = thp_nr_pages(page);

		for (i = 0; i < nr_pages; i++) {
			if (atomic_inc_and_test(&page[i]._mapcount))
				nr++;
		}
		if (!atomic_inc_and_test(compound_mapcount_ptr(page)))
			goto out;

		/*
		 * It is racy to ClearPageDoubleMap in page_remove_file_rmap();
		 * but page lock is held by all page_add_file_rmap() compound
		 * callers, and SetPageDoubleMap below warns if !PageLocked:
		 * so here is a place that DoubleMap can be safely cleared.
		 */
		VM_WARN_ON_ONCE(!PageLocked(page));
		if (nr == nr_pages && PageDoubleMap(page))
			ClearPageDoubleMap(page);

		if (PageSwapBacked(page))
			__mod_lruvec_page_state(page, NR_SHMEM_PMDMAPPED,
						nr_pages);
		else
			__mod_lruvec_page_state(page, NR_FILE_PMDMAPPED,
						nr_pages);
	} else {
		if (PageTransCompound(page) && page_mapping(page)) {
			VM_WARN_ON_ONCE(!PageLocked(page));
			SetPageDoubleMap(compound_head(page));
		}
		if (atomic_inc_and_test(&page->_mapcount))
			nr++;
	}
out:
	if (nr)
		__mod_lruvec_page_state(page, NR_FILE_MAPPED, nr);
	unlock_page_memcg(page);

	mlock_vma_page(page, vma, compound);
}
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:1342-1378
 * Exact source lines, not a restored book listing or standalone program.
 */
static void page_remove_file_rmap(struct page *page, bool compound)
{
	int i, nr = 0;

	VM_BUG_ON_PAGE(compound && !PageHead(page), page);

	/* Hugepages are not counted in NR_FILE_MAPPED for now. */
	if (unlikely(PageHuge(page))) {
		/* hugetlb pages are always mapped with pmds */
		atomic_dec(compound_mapcount_ptr(page));
		return;
	}

	/* page still mapped by someone else? */
	if (compound && PageTransHuge(page)) {
		int nr_pages = thp_nr_pages(page);

		for (i = 0; i < nr_pages; i++) {
			if (atomic_add_negative(-1, &page[i]._mapcount))
				nr++;
		}
		if (!atomic_add_negative(-1, compound_mapcount_ptr(page)))
			goto out;
		if (PageSwapBacked(page))
			__mod_lruvec_page_state(page, NR_SHMEM_PMDMAPPED,
						-nr_pages);
		else
			__mod_lruvec_page_state(page, NR_FILE_PMDMAPPED,
						-nr_pages);
	} else {
		if (atomic_add_negative(-1, &page->_mapcount))
			nr++;
	}
out:
	if (nr)
		__mod_lruvec_page_state(page, NR_FILE_MAPPED, -nr);
}
AVC 해제는 lock 안과 밖의 두 pass로 나뉩니다
첫 pass는 newer-to-older 순서로 interval tree에서 관계를 빼고 counter를 조정합니다. Empty anon_vma의 AVC를 잠시 list에 남기는 것은 누락이 아니라 두 번째 pass의 작업 목록입니다. Active pointer를 NULL로 만든 뒤 root lock을 놓고, 최종 reference 감소와 AVC 반환을 진행합니다.
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:395-448
 * Exact source lines, not a restored book listing or standalone program.
 */
void unlink_anon_vmas(struct vm_area_struct *vma)
{
	struct anon_vma_chain *avc, *next;
	struct anon_vma *root = NULL;

	/*
	 * Unlink each anon_vma chained to the VMA.  This list is ordered
	 * from newest to oldest, ensuring the root anon_vma gets freed last.
	 */
	list_for_each_entry_safe(avc, next, &vma->anon_vma_chain, same_vma) {
		struct anon_vma *anon_vma = avc->anon_vma;

		root = lock_anon_vma_root(root, anon_vma);
		anon_vma_interval_tree_remove(avc, &anon_vma->rb_root);

		/*
		 * Leave empty anon_vmas on the list - we'll need
		 * to free them outside the lock.
		 */
		if (RB_EMPTY_ROOT(&anon_vma->rb_root.rb_root)) {
			anon_vma->parent->num_children--;
			continue;
		}

		list_del(&avc->same_vma);
		anon_vma_chain_free(avc);
	}
	if (vma->anon_vma) {
		vma->anon_vma->num_active_vmas--;

		/*
		 * vma would still be needed after unlink, and anon_vma will be prepared
		 * when handle fault.
		 */
		vma->anon_vma = NULL;
	}
	unlock_anon_vma_root(root);

	/*
	 * Iterate the list once more, it now only contains empty and unlinked
	 * anon_vmas, destroy them. Could not do before due to __put_anon_vma()
	 * needing to write-acquire the anon_vma->root->rwsem.
	 */
	list_for_each_entry_safe(avc, next, &vma->anon_vma_chain, same_vma) {
		struct anon_vma *anon_vma = avc->anon_vma;

		VM_WARN_ON(anon_vma->num_children);
		VM_WARN_ON(anon_vma->num_active_vmas);
		put_anon_vma(anon_vma);

		list_del(&avc->same_vma);
		anon_vma_chain_free(avc);
	}
}
/* SPDX-License-Identifier: GPL-2.0 */

/* Upstream Linux v6.0: include/linux/rmap.h:113-117
 * Exact source lines, not a restored book listing or standalone program.
 */
static inline void put_anon_vma(struct anon_vma *anon_vma)
{
	if (atomic_dec_and_test(&anon_vma->refcount))
		__put_anon_vma(anon_vma);
}
/*
 * mm/rmap.c - physical to virtual reverse mappings
 *
 * Copyright 2001, Rik van Riel <riel@conectiva.com.br>
 * Released under the General Public License (GPL).
 *
 * Simple, low overhead reverse mapping scheme.
 * Please try to keep this thing as modular as possible.
 *
 * Provides methods for unmapping each kind of mapped page:
 * the anon methods track anonymous pages, and
 * the file methods track pages belonging to an inode.
 *
 * Original design by Rik van Riel <riel@conectiva.com.br> 2001
 * File methods by Dave McCracken <dmccr@us.ibm.com> 2003, 2004
 * Anonymous methods by Andrea Arcangeli <andrea@suse.de> 2004
 * Contributions by Hugh Dickins 2003, 2004
 */

/*
 * Lock ordering in mm:
 *
 * inode->i_rwsem	(while writing or truncating, not reading or faulting)
 *   mm->mmap_lock
 *     mapping->invalidate_lock (in filemap_fault)
 *       page->flags PG_locked (lock_page)   * (see hugetlbfs below)
 *         hugetlbfs_i_mmap_rwsem_key (in huge_pmd_share)
 *           mapping->i_mmap_rwsem
 *             hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             anon_vma->rwsem
 *               mm->page_table_lock or pte_lock
 *                 swap_lock (in swap_duplicate, swap_info_get)
 *                   mmlist_lock (in mmput, drain_mmlist and others)
 *                   mapping->private_lock (in block_dirty_folio)
 *                     folio_lock_memcg move_lock (in block_dirty_folio)
 *                       i_pages lock (widely used)
 *                         lruvec->lru_lock (in folio_lruvec_lock_irq)
 *                   inode->i_lock (in set_page_dirty's __mark_inode_dirty)
 *                   bdi.wb->list_lock (in set_page_dirty's __mark_inode_dirty)
 *                     sb_lock (within inode_lock in fs/fs-writeback.c)
 *                     i_pages lock (widely used, in set_page_dirty,
 *                               in arch-dependent flush_dcache_mmap_lock,
 *                               within bdi.wb->list_lock in __sync_single_inode)
 *
 * anon_vma->rwsem,mapping->i_mmap_rwsem   (memory_failure, collect_procs_anon)
 *   ->tasklist_lock
 *     pte map lock
 *
 * * hugetlbfs PageHuge() pages take locks in this order:
 *         mapping->i_mmap_rwsem
 *           hugetlb_fault_mutex (hugetlbfs specific page fault mutex)
 *             page->flags PG_locked (lock_page)
 */

/* Upstream Linux v6.0: mm/rmap.c:2343-2350
 * Exact source lines, not a restored book listing or standalone program.
 */
void __put_anon_vma(struct anon_vma *anon_vma)
{
	struct anon_vma *root = anon_vma->root;

	anon_vma_free(anon_vma);
	if (root != anon_vma && atomic_dec_and_test(&root->refcount))
		anon_vma_free(root);
}
__put_anon_vma()는 child의 object를 반환한 다음, 별도 root가 있다면 그 reference도 감소시킵니다. Root가 해제되는 조건은 단순히 호출 전 count가 어떤 상수였다는 설명보다 atomic_dec_and_test()의 반환으로 읽는 편이 정확합니다. 이는 folio의 data refcount나 PTE mapcount가 아니라 anon_vma 객체의 lifetime입니다.
출처: v6.0 mm/rmap.c, v6.0 include/linux/rmap.h, v6.0 include/linux/pagemap.h. 정확한 line 범위와 source·출력 SHA는 chapter code manifest에 기록했습니다.
참고 자료
Lorenzo Stoakes, The Linux Memory Manager, Chapter 7 §7.0.12–§7.0.14. 현재 folio API는 Linux v6.18 mm/rmap.c, 좌표 변환은 include/linux/pagemap.h를 참고하실 수 있습니다.