파일 내용이 RAM에 있다는 사실과 이 process가 그 내용을 가리키는 PTE를 가졌다는 사실은 다릅니다. 전자는 page cache의 상태이며 후자는 address space의 translation 상태입니다. file read fault는 이 둘을 연결합니다.
callback은 data를, finish는 translation을 준비합니다
v6.0 do_fault()에서 vm_ops->fault callback이 없는 분기는 PMD 자체가 present가 아니면 SIGBUS로, PTE lock 아래 entry가 여전히 비어 있으면 역시 SIGBUS로 처리합니다. entry가 생겼다면 NOPAGE입니다. lock 없이 관찰한 empty entry는 다른 CPU의 PTE read-modify-write가 잠시 clear한 상태일 수 있기 때문입니다. Callback이 있는 정상 missing fault까지 이 SIGBUS 규칙을 적용하지는 않습니다. 사용하지 않은 preallocated PTE table이 남았다면 정상·실패 결과에 관계없이 do_fault()의 cleanup 대상입니다.
callback 기반 VMA의 read는 do_read_fault()로 이어집니다. 일반 page-cache filesystem은 filemap_fault()를 사용하지만 driver나 filesystem마다 같은 callback을 쓰는 것은 아닙니다. fault operation이 없는 VMA도 미리 PTE를 넣는 방식일 수 있으므로, entry가 없다는 관찰은 PTE lock 아래에서 재검사해야 합니다. 정상 backing을 제공할 수 없으면 SIGBUS 결과가 가능합니다.
__do_fault()는 backing의 fault operation을 호출하고, 정상 page 결과에 필요한 folio lock을 확보합니다. VM_FAULT_LOCKED는 callback이 그 lock을 넘겼다는 신호입니다. reference는 object 수명을 지키고 folio lock은 mapping·I/O 관련 상태를 안정화하지만 PTE의 교체를 막는 lock은 아닙니다.
PTE table preallocation은 allocation과 folio lock의 순서 문제를 피합니다. folio를 붙잡은 뒤 table allocation이 reclaim에 들어가고 writeback이 같은 folio를 기다리면 deadlock 관계가 될 수 있습니다. 사용하지 않은 preallocated table은 종료 경로에서 반환합니다.
fault-around와 readahead의 역할
v6.0의 기본 폭은 65536 bytes입니다. debugfs의 fault_around_bytes는 configuration과 mount 여부에 따라 존재하며, 1 base page로 설정하면 fault-around 자체를 하지 않습니다. should_fault_around()의 조건은 “1 page 이상”이 아니라 “1 page 초과”입니다. setter는 큰 값을 power-of-two로 내리고, 작은 값은 1 page로 올리며, val / PAGE_SIZE > PTRS_PER_PTE인 요청은 거부합니다. 여기서는 이 설정을 쓰거나 변경하지 않습니다.
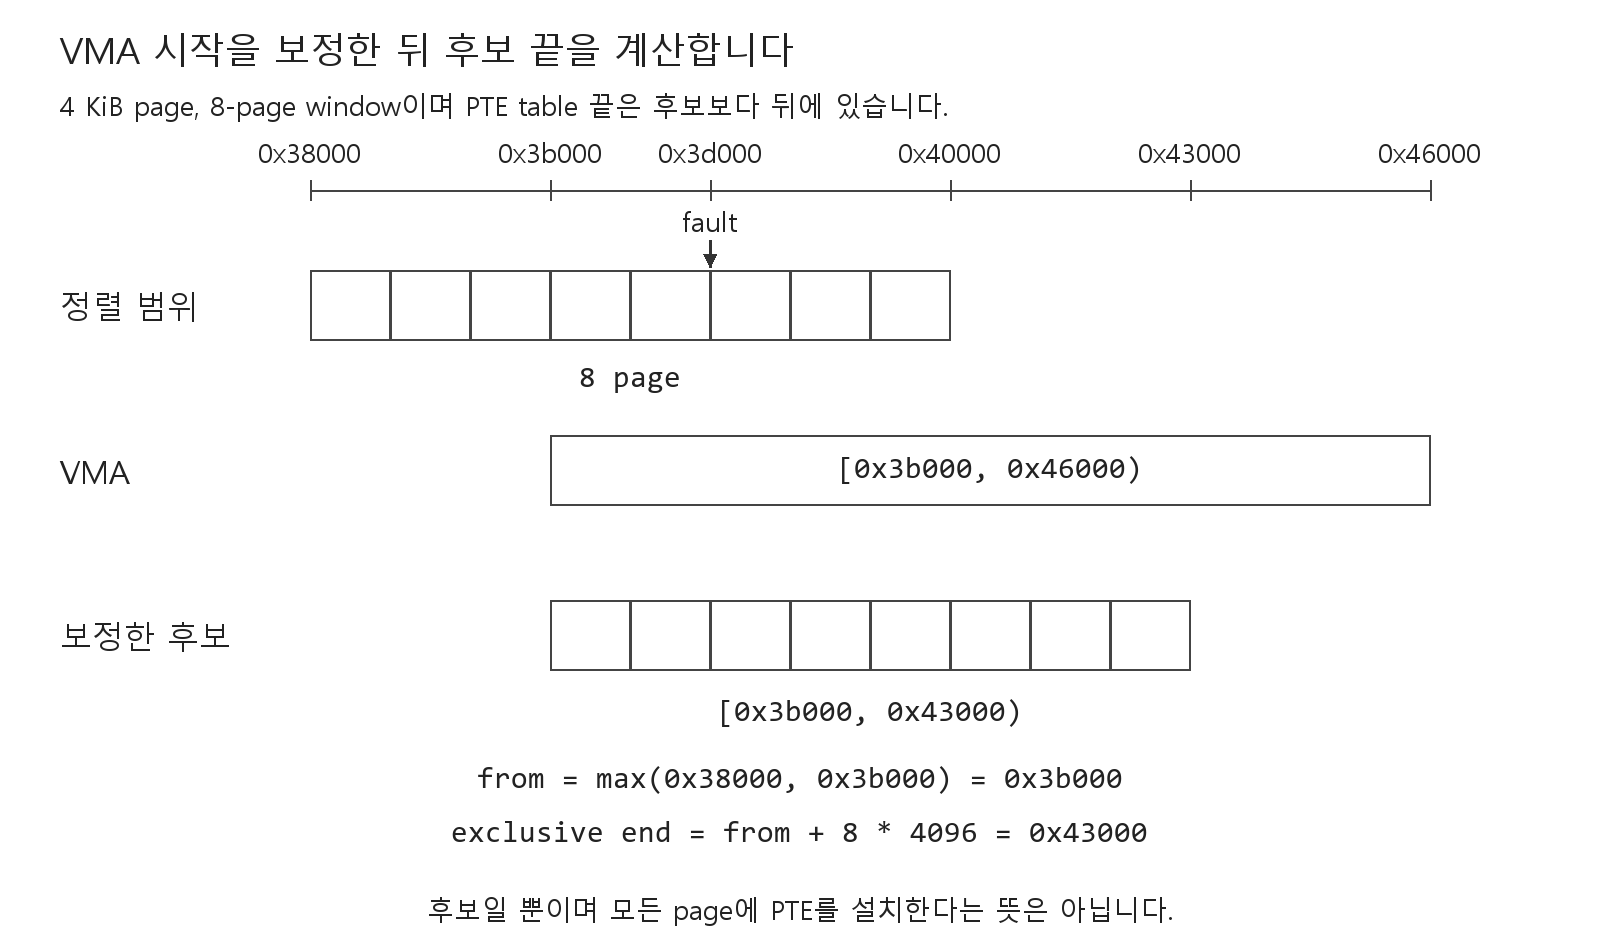
4 KiB base page에서 폭이 64 KiB이고 VMA 경계 제약이 없다면 0xe000의 fault는 [0, 0x10000)의 16 page를 후보로 삼습니다. 마지막 page 시작은 0xf000입니다. 반면 VMA 시작이 0x51000, fault가 0x5f000이면 정렬 시작 0x50000을 그대로 쓸 수 없어 0x51000으로 올립니다. 그 뒤 최대 16 page라는 끝 조건을 다시 적용하므로 최초 정렬 window를 단순히 잘라낸 결과와는 다릅니다.
아래 구현의 start_pgoff는 fault의 backing index에서 새 시작까지의 page 차이를 뺀 값입니다. inclusive end_pgoff는 해당 PTE table의 마지막 index, vm_pgoff + vma_pages - 1, start_pgoff + nr_pages - 1 중 최소입니다. ~(N * PAGE_SIZE - 1)은 낮은 address bit를 지우는 정렬 mask입니다. VMA 시작 보정으로 정렬이 깨질 수 있으므로 PTE table 끝 제한도 별도로 남아 있어야 합니다. 예를 들어 2 MiB PTE-table span의 [0x200000, 0x400000)은 그 table을 벗어나지 않습니다.
v6.18에서는 내부 변수가 fault_around_pages이고 pte_index() 좌표로 시작과 끝을 계산한 뒤 map_pages()를 RCU read-side 구간에서 호출합니다. byte 단위의 debugfs interface와 혼동하지 않도록 아래 코드는 v6.0으로 고정합니다.
map_pages callback은 이미 cache에 있고 즉시 연결 가능한 주변 page를 함께 mapping할 수 있습니다. 이를 fault-around라고 합니다. disk에서 data를 미리 가져오는 readahead와 다릅니다. 주변 cache hole 때문에 모든 candidate가 연결되지는 않으며 target이 해결되지 않으면 일반 fault로 내려갑니다.
candidate 범위는 page 수의 power-of-two 정렬, VMA 시작과 끝, 한 PTE table의 경계로 제한합니다. 시작을 VMA 시작으로 올린 뒤에는 끝도 그 보정된 시작을 기준으로 다시 계산합니다. 최초 정렬 window를 단순히 잘라낸 결과와 다를 수 있습니다. file index는 정한 VA 범위를 vm_pgoff 좌표로 변환하여 얻습니다.
EOF와 truncate는 lock 뒤에도 확인합니다
backing lookup 후 folio lock을 기다리는 동안 truncate가 진행될 수 있습니다. 따라서 처음 찾은 folio가 여전히 같은 mapping에 속하는지, fault index가 현재 file size에서 유효한지 재확인이 필요합니다. reference를 얻었다는 이유로 file size까지 고정되지는 않습니다.
I/O를 기다리려고 mmap lock을 놓았다면 file reference로 backing을 살려 두고 retry합니다. 준비된 page를 과거 VMA pointer에 무조건 설치하지 않습니다. partial EOF page 안의 남은 byte와 EOF를 완전히 넘은 page의 SIGBUS는 별개입니다. fault가 발생한 VA가 VMA 안이라는 사실만으로 정상 contents가 보장되지 않습니다.
설치할 때는 또 다른 경쟁을 확인합니다
v6.0 __do_fault()의 HWPoison 경로는 callback이 넘긴 page를 그대로 설치하지 않습니다. 필요하면 mapping을 해제하고 cache invalidation 결과에 따라 NOPAGE로 재시도하도록 하거나 HWPOISON을 반환하며 page reference를 정리합니다. 일반 성공에서는 callback이 LOCKED를 반환했는지 확인하고, 아니면 직접 folio lock을 얻습니다. finish_fault()는 그 lock을 해제하지 않으므로 read caller가 성공과 실패 모두에서 unlock을 맡습니다.
do_set_pte()의 write-private 분기는 anonymous RSS·새 anon rmap·LRU를 추가하고, 나머지는 mm_counter_file()과 file rmap을 사용합니다. 이미 page cache에 있는 file folio를 여기서 새 anonymous LRU 대상으로 만드는 것이 아닙니다. maybe_mkwrite()는 VMA의 VM_WRITE를 다시 확인하며, prefaulted entry를 old로 시작할지와 software young 처리는 architecture hook에 맡깁니다.
finish_fault()는 page를 선택하고 필요한 table을 마련한 뒤 PTE lock을 얻어 snapshot을 비교합니다. 최초 table이 없었던 경우에는 entry가 여전히 empty인지 확인합니다. 다른 fault가 먼저 해결했다면 새 결과를 덮어쓰지 않고 caller가 lock과 reference를 정리합니다.
normal file page에는 file rmap과 RSS가 연결되며, private write로 만든 anonymous target에는 다른 accounting이 필요합니다. 준비한 data를 얻는 단계와 process translation으로 공개하는 단계를 분리하면 callback의 retry·NOPAGE·error 반환에서도 무엇을 정리해야 하는지 알 수 있습니다.
Linux v6.0의 file read와 fault 완료 전체 정의
callback 이전 table preallocation부터 page lock, snapshot 재검사, 성공 reference 인계까지 한 tag의 전체 정의로 연결합니다. fault-around 범위 계산과 setter도 함께 제시하며, 설정을 변경하는 실습은 수행하지 않습니다.
아래는 Linux v6.0의 전체 함수·자료형 정의입니다. kernel의 header·configuration·호출 규약에 의존하는 코드이며 독립 실행 프로그램은 아닙니다. 본문 해설과는 별도로 각 source의 SPDX license를 적용합니다. 원래 copyright notice는 source notice에, GPL version 2 전문은 license 파일에 보존합니다. 표시상의 tab을 space로 바꾼 것 외에 함수 내부의 문장이나 configuration 분기는 제거하지 않았습니다.
do_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static vm_fault_t do_fault(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    struct mm_struct *vm_mm = vma->vm_mm;
    vm_fault_t ret;

    /*
     * The VMA was not fully populated on mmap() or missing VM_DONTEXPAND
     */
    if (!vma->vm_ops->fault) {
        /*
         * If we find a migration pmd entry or a none pmd entry, which
         * should never happen, return SIGBUS
         */
        if (unlikely(!pmd_present(*vmf->pmd)))
            ret = VM_FAULT_SIGBUS;
        else {
            vmf->pte = pte_offset_map_lock(vmf->vma->vm_mm,
                               vmf->pmd,
                               vmf->address,
                               &vmf->ptl);
            /*
             * Make sure this is not a temporary clearing of pte
             * by holding ptl and checking again. A R/M/W update
             * of pte involves: take ptl, clearing the pte so that
             * we don't have concurrent modification by hardware
             * followed by an update.
             */
            if (unlikely(pte_none(*vmf->pte)))
                ret = VM_FAULT_SIGBUS;
            else
                ret = VM_FAULT_NOPAGE;

            pte_unmap_unlock(vmf->pte, vmf->ptl);
        }
    } else if (!(vmf->flags & FAULT_FLAG_WRITE))
        ret = do_read_fault(vmf);
    else if (!(vma->vm_flags & VM_SHARED))
        ret = do_cow_fault(vmf);
    else
        ret = do_shared_fault(vmf);

    /* preallocated pagetable is unused: free it */
    if (vmf->prealloc_pte) {
        pte_free(vm_mm, vmf->prealloc_pte);
        vmf->prealloc_pte = NULL;
    }
    return ret;
}
do_read_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static vm_fault_t do_read_fault(struct vm_fault *vmf)
{
    vm_fault_t ret = 0;

    /*
     * Let's call ->map_pages() first and use ->fault() as fallback
     * if page by the offset is not ready to be mapped (cold cache or
     * something).
     */
    if (should_fault_around(vmf)) {
        ret = do_fault_around(vmf);
        if (ret)
            return ret;
    }

    ret = __do_fault(vmf);
    if (unlikely(ret & (VM_FAULT_ERROR | VM_FAULT_NOPAGE | VM_FAULT_RETRY)))
        return ret;

    ret |= finish_fault(vmf);
    unlock_page(vmf->page);
    if (unlikely(ret & (VM_FAULT_ERROR | VM_FAULT_NOPAGE | VM_FAULT_RETRY)))
        put_page(vmf->page);
    return ret;
}
should_fault_around()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static inline bool should_fault_around(struct vm_fault *vmf)
{
    /* No ->map_pages?  No way to fault around... */
    if (!vmf->vma->vm_ops->map_pages)
        return false;

    if (uffd_disable_fault_around(vmf->vma))
        return false;

    return fault_around_bytes >> PAGE_SHIFT > 1;
}
do_fault_around()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static vm_fault_t do_fault_around(struct vm_fault *vmf)
{
    unsigned long address = vmf->address, nr_pages, mask;
    pgoff_t start_pgoff = vmf->pgoff;
    pgoff_t end_pgoff;
    int off;

    nr_pages = READ_ONCE(fault_around_bytes) >> PAGE_SHIFT;
    mask = ~(nr_pages * PAGE_SIZE - 1) & PAGE_MASK;

    address = max(address & mask, vmf->vma->vm_start);
    off = ((vmf->address - address) >> PAGE_SHIFT) & (PTRS_PER_PTE - 1);
    start_pgoff -= off;

    /*
     *  end_pgoff is either the end of the page table, the end of
     *  the vma or nr_pages from start_pgoff, depending what is nearest.
     */
    end_pgoff = start_pgoff -
        ((address >> PAGE_SHIFT) & (PTRS_PER_PTE - 1)) +
        PTRS_PER_PTE - 1;
    end_pgoff = min3(end_pgoff, vma_pages(vmf->vma) + vmf->vma->vm_pgoff - 1,
            start_pgoff + nr_pages - 1);

    if (pmd_none(*vmf->pmd)) {
        vmf->prealloc_pte = pte_alloc_one(vmf->vma->vm_mm);
        if (!vmf->prealloc_pte)
            return VM_FAULT_OOM;
    }

    return vmf->vma->vm_ops->map_pages(vmf, start_pgoff, end_pgoff);
}
__do_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static vm_fault_t __do_fault(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    vm_fault_t ret;

    /*
     * Preallocate pte before we take page_lock because this might lead to
     * deadlocks for memcg reclaim which waits for pages under writeback:
     *              lock_page(A)
     *              SetPageWriteback(A)
     *              unlock_page(A)
     * lock_page(B)
     *              lock_page(B)
     * pte_alloc_one
     *   shrink_page_list
     *     wait_on_page_writeback(A)
     *              SetPageWriteback(B)
     *              unlock_page(B)
     *              # flush A, B to clear the writeback
     */
    if (pmd_none(*vmf->pmd) && !vmf->prealloc_pte) {
        vmf->prealloc_pte = pte_alloc_one(vma->vm_mm);
        if (!vmf->prealloc_pte)
            return VM_FAULT_OOM;
    }

    ret = vma->vm_ops->fault(vmf);
    if (unlikely(ret & (VM_FAULT_ERROR | VM_FAULT_NOPAGE | VM_FAULT_RETRY |
                VM_FAULT_DONE_COW)))
        return ret;

    if (unlikely(PageHWPoison(vmf->page))) {
        struct page *page = vmf->page;
        vm_fault_t poisonret = VM_FAULT_HWPOISON;
        if (ret & VM_FAULT_LOCKED) {
            if (page_mapped(page))
                unmap_mapping_pages(page_mapping(page),
                            page->index, 1, false);
            /* Retry if a clean page was removed from the cache. */
            if (invalidate_inode_page(page))
                poisonret = VM_FAULT_NOPAGE;
            unlock_page(page);
        }
        put_page(page);
        vmf->page = NULL;
        return poisonret;
    }

    if (unlikely(!(ret & VM_FAULT_LOCKED)))
        lock_page(vmf->page);
    else
        VM_BUG_ON_PAGE(!PageLocked(vmf->page), vmf->page);

    return ret;
}
finish_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
vm_fault_t finish_fault(struct vm_fault *vmf)
{
    struct vm_area_struct *vma = vmf->vma;
    struct page *page;
    vm_fault_t ret;

    /* Did we COW the page? */
    if ((vmf->flags & FAULT_FLAG_WRITE) && !(vma->vm_flags & VM_SHARED))
        page = vmf->cow_page;
    else
        page = vmf->page;

    /*
     * check even for read faults because we might have lost our CoWed
     * page
     */
    if (!(vma->vm_flags & VM_SHARED)) {
        ret = check_stable_address_space(vma->vm_mm);
        if (ret)
            return ret;
    }

    if (pmd_none(*vmf->pmd)) {
        if (PageTransCompound(page)) {
            ret = do_set_pmd(vmf, page);
            if (ret != VM_FAULT_FALLBACK)
                return ret;
        }

        if (vmf->prealloc_pte)
            pmd_install(vma->vm_mm, vmf->pmd, &vmf->prealloc_pte);
        else if (unlikely(pte_alloc(vma->vm_mm, vmf->pmd)))
            return VM_FAULT_OOM;
    }

    /*
     * See comment in handle_pte_fault() for how this scenario happens, we
     * need to return NOPAGE so that we drop this page.
     */
    if (pmd_devmap_trans_unstable(vmf->pmd))
        return VM_FAULT_NOPAGE;

    vmf->pte = pte_offset_map_lock(vma->vm_mm, vmf->pmd,
                      vmf->address, &vmf->ptl);

    /* Re-check under ptl */
    if (likely(!vmf_pte_changed(vmf))) {
        do_set_pte(vmf, page, vmf->address);

        /* no need to invalidate: a not-present page won't be cached */
        update_mmu_cache(vma, vmf->address, vmf->pte);

        ret = 0;
    } else {
        update_mmu_tlb(vma, vmf->address, vmf->pte);
        ret = VM_FAULT_NOPAGE;
    }

    pte_unmap_unlock(vmf->pte, vmf->ptl);
    return ret;
}
vmf_pte_changed()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static bool vmf_pte_changed(struct vm_fault *vmf)
{
    if (vmf->flags & FAULT_FLAG_ORIG_PTE_VALID)
        return !pte_same(*vmf->pte, vmf->orig_pte);

    return !pte_none(*vmf->pte);
}
do_set_pte()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
void do_set_pte(struct vm_fault *vmf, struct page *page, unsigned long addr)
{
    struct vm_area_struct *vma = vmf->vma;
    bool uffd_wp = pte_marker_uffd_wp(vmf->orig_pte);
    bool write = vmf->flags & FAULT_FLAG_WRITE;
    bool prefault = vmf->address != addr;
    pte_t entry;

    flush_icache_page(vma, page);
    entry = mk_pte(page, vma->vm_page_prot);

    if (prefault && arch_wants_old_prefaulted_pte())
        entry = pte_mkold(entry);
    else
        entry = pte_sw_mkyoung(entry);

    if (write)
        entry = maybe_mkwrite(pte_mkdirty(entry), vma);
    if (unlikely(uffd_wp))
        entry = pte_mkuffd_wp(pte_wrprotect(entry));
    /* copy-on-write page */
    if (write && !(vma->vm_flags & VM_SHARED)) {
        inc_mm_counter_fast(vma->vm_mm, MM_ANONPAGES);
        page_add_new_anon_rmap(page, vma, addr);
        lru_cache_add_inactive_or_unevictable(page, vma);
    } else {
        inc_mm_counter_fast(vma->vm_mm, mm_counter_file(page));
        page_add_file_rmap(page, vma, false);
    }
    set_pte_at(vma->vm_mm, addr, vmf->pte, entry);
}
fault_around_bytes_set()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static int fault_around_bytes_set(void *data, u64 val)
{
    if (val / PAGE_SIZE > PTRS_PER_PTE)
        return -EINVAL;
    if (val > PAGE_SIZE)
        fault_around_bytes = rounddown_pow_of_two(val);
    else
        fault_around_bytes = PAGE_SIZE; /* rounddown_pow_of_two(0) is undefined */
    return 0;
}
참고 자료
Lorenzo Stoakes, The Linux Memory Manager, Chapter 6 §6.4–§6.5, §6.8. Linux v6.18 mm/memory.c, mm/filemap.c를 참고하실 수 있습니다.