page fault에서 가장 중요한 분기 중 하나는 “present인가”보다 먼저 “비어 있는가”입니다. 아직 아무것도 연결하지 않은 주소와 swap·migration 등의 상태를 저장한 entry는 다음 동작이 다르기 때문입니다.
vm_fault에 저장하는 작업 상태
v6.0 handle_mm_fault()는 task를 TASK_RUNNING으로 두고 global PGFAULT·memcg event·RSS 동기화 통계를 처리합니다. architecture permission 검사 뒤 hugetlb VMA는 별도 handler로, 나머지는 __handle_mm_fault()로 갑니다. USER fault의 memcg OOM 진입·종료 상태도 짝을 맞추며, 내부 allocation 실패를 다른 방식으로 해결하여 OOM 결과가 사라졌다면 불필요한 kill 없이 상태를 정리할 수 있습니다. 마지막의 major/minor accounting은 handler의 결과를 소비합니다.
gfp_mask는 anonymous page의 모든 allocation flag를 뜻하지 않습니다. 이 state를 사용하는 file fault allocation에 전달할 mask는 __get_fault_gfp_mask()로 정하며, file이 없으면 GFP_KERNEL, file이 있으면 해당 mapping의 mask에 __GFP_FS와 __GFP_IO를 더하는 v6.0 계약입니다. pgoff는 VMA 내부의 0부터 세는 번호만이 아니라 vm_pgoff를 포함한 backing의 논리 page index입니다. prealloc_pte는 callback이 잠들 수 없는 구간에 들어가기 전에 준비한 table이며, 사용하지 않으면 caller가 반환합니다.
handle_mm_fault()는 architecture의 허용 검사를 거쳐 공통 handler를 수행하고 fault 통계를 정리합니다. hardware exception 외에 GUP와 다른 kernel caller도 이 interface를 사용합니다. 따라서 WRITE는 반드시 “기존 present PTE의 write protection 위반”만 뜻하지 않습니다. empty PTE의 첫 write도 write fault입니다.
struct vm_fault에는 VMA, 정렬된 address와 원래 address, 논리 pgoff, GFP 조건이 들어갑니다. 진행 중에는 PUD·PMD·PTE pointer, PTE lock, 최초 entry snapshot, 반환 page, private copy를 위한 cow_page, 미리 allocation한 PTE table 등을 보관합니다. 최초 snapshot과 현재 entry를 구별해야 lock을 놓고 작업한 사이의 경쟁을 발견할 수 있습니다.
fault flags는 요청과 대기 정책입니다. USER는 주소가 아니라 발생 mode, REMOTE는 다른 mm 접근, INSTRUCTION은 instruction fetch를 뜻합니다. MKWRITE는 backing의 writable 승인 callback에, UNSHARE는 read pin을 위해 anonymous 공유를 끊는 요청에 관계합니다. UNSHARE와 WRITE는 동시에 요청하지 않습니다. KILLABLE·INTERRUPTIBLE·RETRY_NOWAIT는 기다릴 수 있는 상황을 제한하며 permission을 추가하지 않습니다.
v6.0의 ALLOW_RETRY는 __folio_lock_or_retry()나 file fault의 lock 대기 경로가 mmap lock을 놓고 caller에게 재탐색을 맡길 수 있게 합니다. TRIED는 첫 시도 전용 최적화를 다시 사용하지 않도록 구분합니다. RETRY_NOWAIT를 함께 지정한 caller는 해당 lock 대기에서 mmap lock을 놓거나 folio unlock을 기다리지 않는 계약을 요구합니다. hardware fault와 GUP의 nonblocking 요청을 같은 lock 반환 규칙으로 합치면 안 됩니다. KILLABLE은 killable lock·wait를 선택하며, INTERRUPTIBLE은 userfaultfd 등 해당 flag를 소비하는 대기 경로에만 영향을 줍니다. 모든 allocation이나 I/O를 일괄 nonblocking으로 바꾸는 flag는 아닙니다.
data page보다 table page가 먼저 필요할 수 있습니다
v6.0 x86-64에서 실제 존재하는 P4D allocation은 p4d_alloc_one()의 GFP_KERNEL_ACCOUNT, PUD는 __pud_alloc_one()의 GFP_PGTABLE_USER, PMD는 pmd_alloc_one()의 GFP_PGTABLE_USER를 사용합니다. P4D·PUD의 zeroed page와 PMD allocator의 constructor·zeroing을 포함한 table 준비를 일반 user data allocation과 혼동하지 않아야 합니다. folded level은 이 비용이 없으며, 활성화된 paging level과 configuration에 따라 실제 allocation은 달라집니다.
이 allocation 조건의 직접 근거는 v6.0 x86 pgalloc.h와 asm-generic/pgalloc.h입니다. user mm과 init_mm의 accounting flag 선택도 같지 않습니다.
아래 v6.0 전체 코드에는 huge PUD·PMD, migration PMD와 devmap 분기도 그대로 남아 있습니다. PMD가 huge leaf로 바뀌었을 가능성을 먼저 검사하지 않고 곧장 PTE table로 해석해서는 안 됩니다. snapshot을 읽는 시점의 compiler barrier는 PTE lock을 획득한 것과도 다릅니다. word size보다 큰 PTE가 가능한 architecture의 관찰 문제와, 최종 수정 직전의 경쟁 검사를 구분해야 합니다.
page-table walk는 필요한 중간 table을 allocation하면서 아래로 내려갑니다. folded level은 실제 allocation이 없고, huge leaf는 해당 level에서 따로 처리합니다. table allocation 자체가 실패해도 OOM 결과가 가능합니다. “anonymous read는 zero page만 쓰므로 allocation이 전혀 없다”는 설명은 table memory를 빠뜨립니다.
PTE level에서는 entry를 읽어 orig_pte에 보관할 수 있습니다. snapshot을 읽은 것과 entry를 독점한 것은 다르므로 실제 수정 전에는 PTE lock 아래에서 다시 비교해야 합니다. VMA lock은 page-table lock을 대신하지 않습니다.
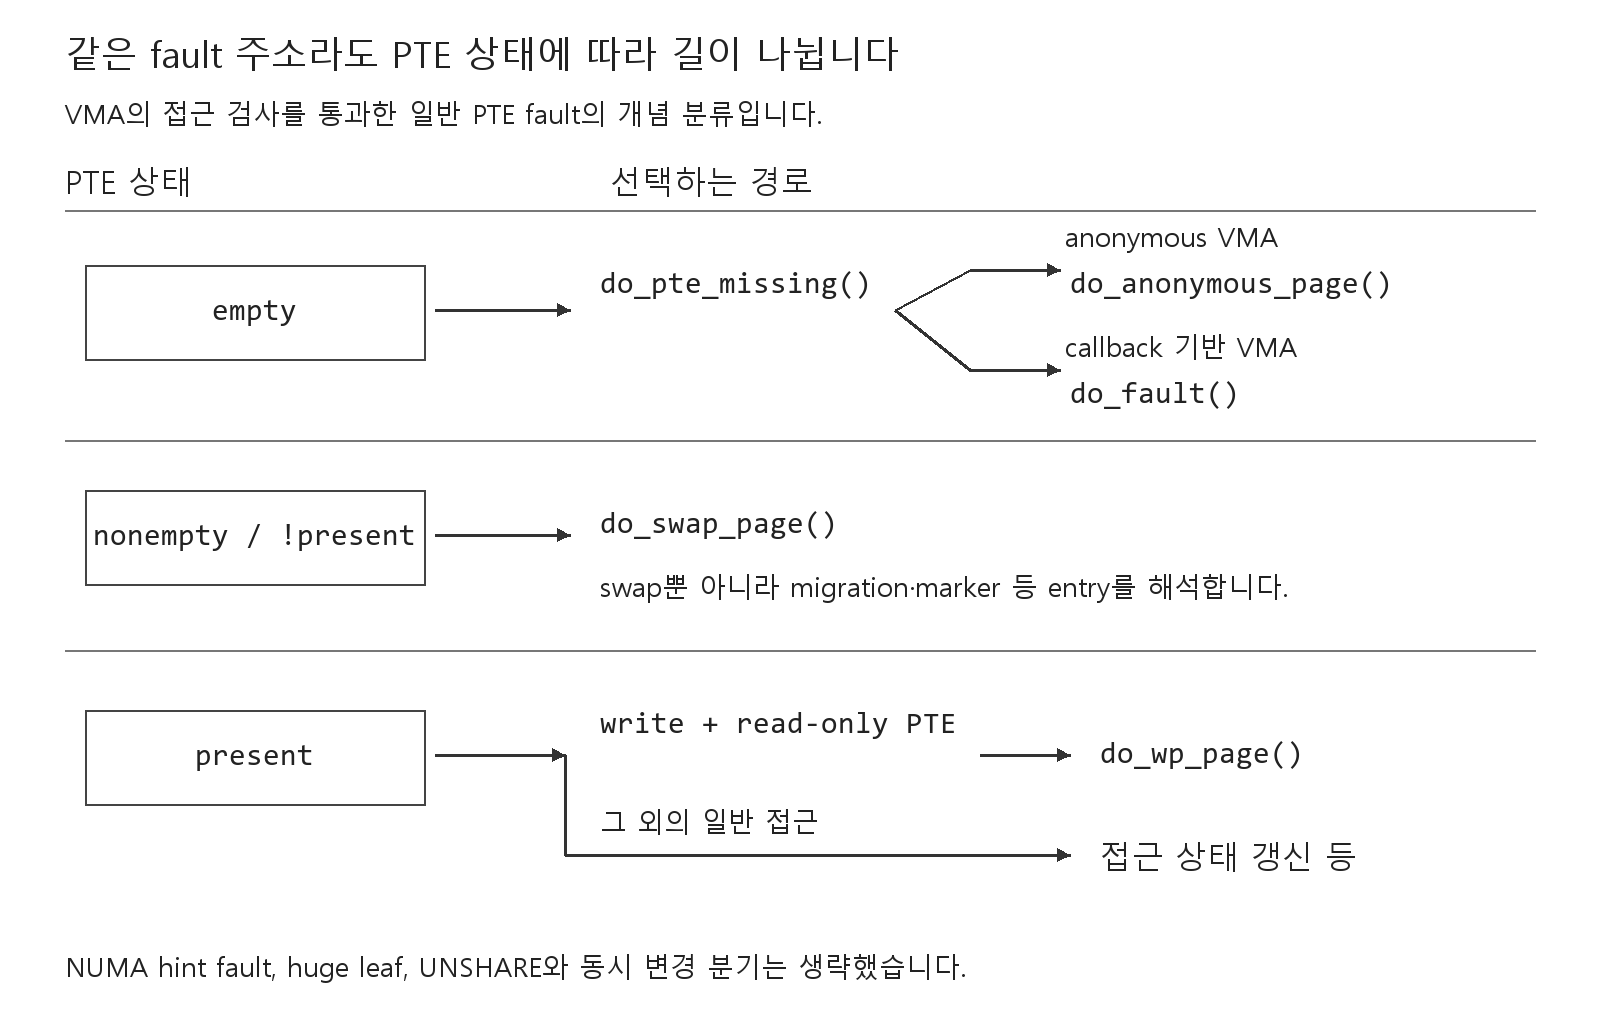
그림의 do_pte_missing()은 v6.18의 helper 명칭입니다. 아래에 싣는 v6.0에서는 같은 missing-PTE 분기가 handle_pte_fault() 안에 있으므로, 그림의 함수명을 v6.0 call graph에 그대로 추가하시면 안 됩니다. 두 tag의 실제 source를 구별한 독립적인 상태 분류도입니다.
missing, swap-like, write-protection
vm_page_prot는 VM_SHARED·READ·WRITE·EXEC에서 얻은 기본 protection입니다. private writable VMA의 기본 protection은 CoW를 위해 read-only일 수 있지만, 실제 private page를 새로 공급하거나 reuse한 뒤까지 모든 PTE가 read-only인 것은 아닙니다. shared file도 write notification 때문에 기본 protection을 낮출 수 있습니다. 그러므로 기본 protection, 현재 PTE permission, VMA가 허용하는 permission을 각각 읽어야 합니다.
empty entry는 anonymous VMA이면 zero-fill 계열, callback 기반 VMA이면 file·driver fault 계열로 갑니다. MAP_ANONYMOUS | MAP_SHARED는 shmem operation이 있으므로 보통의 private anonymous 분기와 다릅니다. vma_is_anonymous()를 “이 VMA에 file descriptor가 없었는가”로 바꾸어 읽으면 안 됩니다.
비어 있지 않지만 Linux의 present 판정이 false인 entry는 do_swap_page() 계열로 갈 수 있습니다. 여기에 swap disk 위치만 들어가는 것은 아닙니다. migration·device 관련 entry와 marker 등은 별도 분기를 가집니다. hardware present bit와 Linux의 pte_present()도 동일하지 않을 수 있으며 x86 PROTNONE은 중요한 예입니다.
present mapping의 NUMA hinting은 NUMA 처리로, write가 허용된 VMA의 read-only entry는 do_wp_page()로 이어집니다. read 또는 spurious write에서는 young·dirty 등 access 상태만 갱신하고 끝날 수 있습니다. 경쟁이 먼저 fault를 해결했다면 현재 entry를 덮지 않고 종료합니다.
공통된 질문은 네 가지입니다. VMA가 이 접근을 허용하는지, entry가 어떤 상태를 기록하는지, backing이 무엇인지, lock 아래에서도 최초 관찰이 유효한지입니다. 이 순서를 지키면 함수 이름이 tag마다 나뉘거나 바뀌어도 fault의 의미를 추적할 수 있습니다.
Linux v6.0의 fault state와 dispatch 전체 정의
입력 flags와 결과 bitmap, 작업 state, table allocation과 PTE 분기를 같은 tag에서 읽습니다. 아래 enum의 VM_FAULT_WRITE와 FAULT_FLAG_ORIG_PTE_VALID는 이 버전의 interface이며 최신 tag에 임의로 대입하지 않습니다.
아래는 Linux v6.0의 전체 함수·자료형 정의입니다. kernel의 header·configuration·호출 규약에 의존하는 코드이며 독립 실행 프로그램은 아닙니다. 본문 해설과는 별도로 각 source의 SPDX license를 적용합니다. 원래 copyright notice는 source notice에, GPL version 2 전문은 license 파일에 보존합니다. 표시상의 tab을 space로 바꾼 것 외에 함수 내부의 문장이나 configuration 분기는 제거하지 않았습니다.
handle_mm_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
vm_fault_t handle_mm_fault(struct vm_area_struct *vma, unsigned long address,
               unsigned int flags, struct pt_regs *regs)
{
    vm_fault_t ret;

    __set_current_state(TASK_RUNNING);

    count_vm_event(PGFAULT);
    count_memcg_event_mm(vma->vm_mm, PGFAULT);

    /* do counter updates before entering really critical section. */
    check_sync_rss_stat(current);

    if (!arch_vma_access_permitted(vma, flags & FAULT_FLAG_WRITE,
                        flags & FAULT_FLAG_INSTRUCTION,
                        flags & FAULT_FLAG_REMOTE))
        return VM_FAULT_SIGSEGV;

    /*
     * Enable the memcg OOM handling for faults triggered in user
     * space.  Kernel faults are handled more gracefully.
     */
    if (flags & FAULT_FLAG_USER)
        mem_cgroup_enter_user_fault();

    if (unlikely(is_vm_hugetlb_page(vma)))
        ret = hugetlb_fault(vma->vm_mm, vma, address, flags);
    else
        ret = __handle_mm_fault(vma, address, flags);

    if (flags & FAULT_FLAG_USER) {
        mem_cgroup_exit_user_fault();
        /*
         * The task may have entered a memcg OOM situation but
         * if the allocation error was handled gracefully (no
         * VM_FAULT_OOM), there is no need to kill anything.
         * Just clean up the OOM state peacefully.
         */
        if (task_in_memcg_oom(current) && !(ret & VM_FAULT_OOM))
            mem_cgroup_oom_synchronize(false);
    }

    mm_account_fault(regs, address, flags, ret);

    return ret;
}
__handle_mm_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static vm_fault_t __handle_mm_fault(struct vm_area_struct *vma,
        unsigned long address, unsigned int flags)
{
    struct vm_fault vmf = {
        .vma = vma,
        .address = address & PAGE_MASK,
        .real_address = address,
        .flags = flags,
        .pgoff = linear_page_index(vma, address),
        .gfp_mask = __get_fault_gfp_mask(vma),
    };
    struct mm_struct *mm = vma->vm_mm;
    unsigned long vm_flags = vma->vm_flags;
    pgd_t *pgd;
    p4d_t *p4d;
    vm_fault_t ret;

    pgd = pgd_offset(mm, address);
    p4d = p4d_alloc(mm, pgd, address);
    if (!p4d)
        return VM_FAULT_OOM;

    vmf.pud = pud_alloc(mm, p4d, address);
    if (!vmf.pud)
        return VM_FAULT_OOM;
retry_pud:
    if (pud_none(*vmf.pud) &&
        hugepage_vma_check(vma, vm_flags, false, true)) {
        ret = create_huge_pud(&vmf);
        if (!(ret & VM_FAULT_FALLBACK))
            return ret;
    } else {
        pud_t orig_pud = *vmf.pud;

        barrier();
        if (pud_trans_huge(orig_pud) || pud_devmap(orig_pud)) {

            /*
             * TODO once we support anonymous PUDs: NUMA case and
             * FAULT_FLAG_UNSHARE handling.
             */
            if ((flags & FAULT_FLAG_WRITE) && !pud_write(orig_pud)) {
                ret = wp_huge_pud(&vmf, orig_pud);
                if (!(ret & VM_FAULT_FALLBACK))
                    return ret;
            } else {
                huge_pud_set_accessed(&vmf, orig_pud);
                return 0;
            }
        }
    }

    vmf.pmd = pmd_alloc(mm, vmf.pud, address);
    if (!vmf.pmd)
        return VM_FAULT_OOM;

    /* Huge pud page fault raced with pmd_alloc? */
    if (pud_trans_unstable(vmf.pud))
        goto retry_pud;

    if (pmd_none(*vmf.pmd) &&
        hugepage_vma_check(vma, vm_flags, false, true)) {
        ret = create_huge_pmd(&vmf);
        if (!(ret & VM_FAULT_FALLBACK))
            return ret;
    } else {
        vmf.orig_pmd = *vmf.pmd;

        barrier();
        if (unlikely(is_swap_pmd(vmf.orig_pmd))) {
            VM_BUG_ON(thp_migration_supported() &&
                      !is_pmd_migration_entry(vmf.orig_pmd));
            if (is_pmd_migration_entry(vmf.orig_pmd))
                pmd_migration_entry_wait(mm, vmf.pmd);
            return 0;
        }
        if (pmd_trans_huge(vmf.orig_pmd) || pmd_devmap(vmf.orig_pmd)) {
            if (pmd_protnone(vmf.orig_pmd) && vma_is_accessible(vma))
                return do_huge_pmd_numa_page(&vmf);

            if ((flags & (FAULT_FLAG_WRITE|FAULT_FLAG_UNSHARE)) &&
                !pmd_write(vmf.orig_pmd)) {
                ret = wp_huge_pmd(&vmf);
                if (!(ret & VM_FAULT_FALLBACK))
                    return ret;
            } else {
                huge_pmd_set_accessed(&vmf);
                return 0;
            }
        }
    }

    return handle_pte_fault(&vmf);
}
handle_pte_fault()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static vm_fault_t handle_pte_fault(struct vm_fault *vmf)
{
    pte_t entry;

    if (unlikely(pmd_none(*vmf->pmd))) {
        /*
         * Leave __pte_alloc() until later: because vm_ops->fault may
         * want to allocate huge page, and if we expose page table
         * for an instant, it will be difficult to retract from
         * concurrent faults and from rmap lookups.
         */
        vmf->pte = NULL;
        vmf->flags &= ~FAULT_FLAG_ORIG_PTE_VALID;
    } else {
        /*
         * If a huge pmd materialized under us just retry later.  Use
         * pmd_trans_unstable() via pmd_devmap_trans_unstable() instead
         * of pmd_trans_huge() to ensure the pmd didn't become
         * pmd_trans_huge under us and then back to pmd_none, as a
         * result of MADV_DONTNEED running immediately after a huge pmd
         * fault in a different thread of this mm, in turn leading to a
         * misleading pmd_trans_huge() retval. All we have to ensure is
         * that it is a regular pmd that we can walk with
         * pte_offset_map() and we can do that through an atomic read
         * in C, which is what pmd_trans_unstable() provides.
         */
        if (pmd_devmap_trans_unstable(vmf->pmd))
            return 0;
        /*
         * A regular pmd is established and it can't morph into a huge
         * pmd from under us anymore at this point because we hold the
         * mmap_lock read mode and khugepaged takes it in write mode.
         * So now it's safe to run pte_offset_map().
         */
        vmf->pte = pte_offset_map(vmf->pmd, vmf->address);
        vmf->orig_pte = *vmf->pte;
        vmf->flags |= FAULT_FLAG_ORIG_PTE_VALID;

        /*
         * some architectures can have larger ptes than wordsize,
         * e.g.ppc44x-defconfig has CONFIG_PTE_64BIT=y and
         * CONFIG_32BIT=y, so READ_ONCE cannot guarantee atomic
         * accesses.  The code below just needs a consistent view
         * for the ifs and we later double check anyway with the
         * ptl lock held. So here a barrier will do.
         */
        barrier();
        if (pte_none(vmf->orig_pte)) {
            pte_unmap(vmf->pte);
            vmf->pte = NULL;
        }
    }

    if (!vmf->pte) {
        if (vma_is_anonymous(vmf->vma))
            return do_anonymous_page(vmf);
        else
            return do_fault(vmf);
    }

    if (!pte_present(vmf->orig_pte))
        return do_swap_page(vmf);

    if (pte_protnone(vmf->orig_pte) && vma_is_accessible(vmf->vma))
        return do_numa_page(vmf);

    vmf->ptl = pte_lockptr(vmf->vma->vm_mm, vmf->pmd);
    spin_lock(vmf->ptl);
    entry = vmf->orig_pte;
    if (unlikely(!pte_same(*vmf->pte, entry))) {
        update_mmu_tlb(vmf->vma, vmf->address, vmf->pte);
        goto unlock;
    }
    if (vmf->flags & (FAULT_FLAG_WRITE|FAULT_FLAG_UNSHARE)) {
        if (!pte_write(entry))
            return do_wp_page(vmf);
        else if (likely(vmf->flags & FAULT_FLAG_WRITE))
            entry = pte_mkdirty(entry);
    }
    entry = pte_mkyoung(entry);
    if (ptep_set_access_flags(vmf->vma, vmf->address, vmf->pte, entry,
                vmf->flags & FAULT_FLAG_WRITE)) {
        update_mmu_cache(vmf->vma, vmf->address, vmf->pte);
    } else {
        /* Skip spurious TLB flush for retried page fault */
        if (vmf->flags & FAULT_FLAG_TRIED)
            goto unlock;
        /*
         * This is needed only for protection faults but the arch code
         * is not yet telling us if this is a protection fault or not.
         * This still avoids useless tlb flushes for .text page faults
         * with threads.
         */
        if (vmf->flags & FAULT_FLAG_WRITE)
            flush_tlb_fix_spurious_fault(vmf->vma, vmf->address);
    }
unlock:
    pte_unmap_unlock(vmf->pte, vmf->ptl);
    return 0;
}
struct vm_fault
Linux v6.0 include/linux/mm.h, SPDX GPL-2.0입니다.
struct vm_fault {
    const struct {
        struct vm_area_struct *vma; /* Target VMA */
        gfp_t gfp_mask;         /* gfp mask to be used for allocations */
        pgoff_t pgoff;          /* Logical page offset based on vma */
        unsigned long address;      /* Faulting virtual address - masked */
        unsigned long real_address; /* Faulting virtual address - unmasked */
    };
    enum fault_flag flags;      /* FAULT_FLAG_xxx flags
                     * XXX: should really be 'const' */
    pmd_t *pmd;         /* Pointer to pmd entry matching
                     * the 'address' */
    pud_t *pud;         /* Pointer to pud entry matching
                     * the 'address'
                     */
    union {
        pte_t orig_pte;     /* Value of PTE at the time of fault */
        pmd_t orig_pmd;     /* Value of PMD at the time of fault,
                     * used by PMD fault only.
                     */
    };

    struct page *cow_page;      /* Page handler may use for COW fault */
    struct page *page;      /* ->fault handlers should return a
                     * page here, unless VM_FAULT_NOPAGE
                     * is set (which is also implied by
                     * VM_FAULT_ERROR).
                     */
    /* These three entries are valid only while holding ptl lock */
    pte_t *pte;         /* Pointer to pte entry matching
                     * the 'address'. NULL if the page
                     * table hasn't been allocated.
                     */
    spinlock_t *ptl;        /* Page table lock.
                     * Protects pte page table if 'pte'
                     * is not NULL, otherwise pmd.
                     */
    pgtable_t prealloc_pte;     /* Pre-allocated pte page table.
                     * vm_ops->map_pages() sets up a page
                     * table from atomic context.
                     * do_fault_around() pre-allocates
                     * page table to avoid allocation from
                     * atomic context.
                     */
};
vma_is_anonymous()
Linux v6.0 include/linux/mm.h, SPDX GPL-2.0입니다.
static inline bool vma_is_anonymous(struct vm_area_struct *vma)
{
    return !vma->vm_ops;
}
enum fault_flag
Linux v6.0 include/linux/mm_types.h, SPDX GPL-2.0입니다.
enum fault_flag {
    FAULT_FLAG_WRITE =      1 << 0,
    FAULT_FLAG_MKWRITE =        1 << 1,
    FAULT_FLAG_ALLOW_RETRY =    1 << 2,
    FAULT_FLAG_RETRY_NOWAIT =   1 << 3,
    FAULT_FLAG_KILLABLE =       1 << 4,
    FAULT_FLAG_TRIED =      1 << 5,
    FAULT_FLAG_USER =       1 << 6,
    FAULT_FLAG_REMOTE =     1 << 7,
    FAULT_FLAG_INSTRUCTION =    1 << 8,
    FAULT_FLAG_INTERRUPTIBLE =  1 << 9,
    FAULT_FLAG_UNSHARE =        1 << 10,
    FAULT_FLAG_ORIG_PTE_VALID = 1 << 11,
};
enum vm_fault_reason
Linux v6.0 include/linux/mm_types.h, SPDX GPL-2.0입니다.
enum vm_fault_reason {
    VM_FAULT_OOM            = (__force vm_fault_t)0x000001,
    VM_FAULT_SIGBUS         = (__force vm_fault_t)0x000002,
    VM_FAULT_MAJOR          = (__force vm_fault_t)0x000004,
    VM_FAULT_WRITE          = (__force vm_fault_t)0x000008,
    VM_FAULT_HWPOISON       = (__force vm_fault_t)0x000010,
    VM_FAULT_HWPOISON_LARGE = (__force vm_fault_t)0x000020,
    VM_FAULT_SIGSEGV        = (__force vm_fault_t)0x000040,
    VM_FAULT_NOPAGE         = (__force vm_fault_t)0x000100,
    VM_FAULT_LOCKED         = (__force vm_fault_t)0x000200,
    VM_FAULT_RETRY          = (__force vm_fault_t)0x000400,
    VM_FAULT_FALLBACK       = (__force vm_fault_t)0x000800,
    VM_FAULT_DONE_COW       = (__force vm_fault_t)0x001000,
    VM_FAULT_NEEDDSYNC      = (__force vm_fault_t)0x002000,
    VM_FAULT_COMPLETED      = (__force vm_fault_t)0x004000,
    VM_FAULT_HINDEX_MASK    = (__force vm_fault_t)0x0f0000,
};
__get_fault_gfp_mask()
Linux v6.0 mm/memory.c, SPDX GPL-2.0-only입니다.
static gfp_t __get_fault_gfp_mask(struct vm_area_struct *vma)
{
    struct file *vm_file = vma->vm_file;

    if (vm_file)
        return mapping_gfp_mask(vm_file->f_mapping) | __GFP_FS | __GFP_IO;

    /*
     * Special mappings (e.g. VDSO) do not have any file so fake
     * a default GFP_KERNEL for them.
     */
    return GFP_KERNEL;
}
p4d_alloc_one()
Linux v6.0 arch/x86/include/asm/pgalloc.h, SPDX GPL-2.0입니다.
static inline p4d_t *p4d_alloc_one(struct mm_struct *mm, unsigned long addr)
{
    gfp_t gfp = GFP_KERNEL_ACCOUNT;

    if (mm == &init_mm)
        gfp &= ~__GFP_ACCOUNT;
    return (p4d_t *)get_zeroed_page(gfp);
}
__pud_alloc_one()
Linux v6.0 include/asm-generic/pgalloc.h, SPDX GPL-2.0입니다.
static inline pud_t *__pud_alloc_one(struct mm_struct *mm, unsigned long addr)
{
    gfp_t gfp = GFP_PGTABLE_USER;

    if (mm == &init_mm)
        gfp = GFP_PGTABLE_KERNEL;
    return (pud_t *)get_zeroed_page(gfp);
}
pmd_alloc_one()
Linux v6.0 include/asm-generic/pgalloc.h, SPDX GPL-2.0입니다.
static inline pmd_t *pmd_alloc_one(struct mm_struct *mm, unsigned long addr)
{
    struct page *page;
    gfp_t gfp = GFP_PGTABLE_USER;

    if (mm == &init_mm)
        gfp = GFP_PGTABLE_KERNEL;
    page = alloc_pages(gfp, 0);
    if (!page)
        return NULL;
    if (!pgtable_pmd_page_ctor(page)) {
        __free_pages(page, 0);
        return NULL;
    }
    return (pmd_t *)page_address(page);
}
기본 flags와 error mask
v6.0 include/linux/mm.h와 include/linux/mm_types.h의 macro 전체입니다. 두 header의 SPDX는 GPL-2.0입니다. ERROR mask에 RETRY와 COMPLETED가 포함되지 않는다는 점도 caller의 검사 순서를 읽을 때 중요합니다.
#define FAULT_FLAG_DEFAULT  (FAULT_FLAG_ALLOW_RETRY | \
                             FAULT_FLAG_KILLABLE | \
                             FAULT_FLAG_INTERRUPTIBLE)

#define VM_FAULT_ERROR (VM_FAULT_OOM | VM_FAULT_SIGBUS | \
                       VM_FAULT_SIGSEGV | VM_FAULT_HWPOISON | \
                       VM_FAULT_HWPOISON_LARGE | VM_FAULT_FALLBACK)
참고 자료
Lorenzo Stoakes, The Linux Memory Manager, Chapter 6 §6.2–§6.2.2. 현재 missing-PTE dispatch와 상태 검사는 Linux v6.18 mm/memory.c, flags와 작업 state는 include/linux/mm_types.h에 있습니다.