이 코드는 어떤 문제를 푸나요?
spinlock은 여러 CPU가 공유 상태를 동시에 수정하지 않도록 임계 구역의 진입을 조정합니다. 여기서는 일반 non-RT 헤더의 얇은 래퍼를 읽어 spinlock_t 안의 raw 잠금으로 연결되는 모습을 봅니다. PREEMPT_RT의 구현과 IRQ 상태 제어를 같은 것으로 가정하면 안 됩니다.
읽을 범위: v6.18.37 · include/linux/spinlock.h · spin_lock 349–352행입니다. 아래에 이 범위의 원문과 각 줄의 설명을 실었습니다. 주제 전체의 흐름과 다른 경로는 기존 분석에서 함께 읽으실 수 있습니다.
먼저 알아둘 개념
임계 구역
동시에 실행되면 불일치가 생기는 공유 데이터 접근 구간입니다.
IRQ 마스킹
같은 CPU에서 인터럽트 핸들러가 끼어드는 것을 제어합니다. CPU 사이의 잠금과 다른 축입니다.
처음 읽을 때
두 CPU가 같은 잠금 객체를 사용해야 같은 임계 구역을 보호합니다. 아래 네 줄은 non-RT 래퍼이며 실제 대기 방식은 raw 잠금과 아키텍처 구현 안에 있습니다.
더 깊이 살펴볼 때
같은 CPU에서 IRQ 처리기가 같은 잠금을 잡을 수 있는지, 임계 구역에서 잠들 수 있는 호출이 있는지 확인해 보세요. non-RT spinlock을 잡은 채 잠드는 코드를 넣으면 안 되며 PREEMPT_RT의 spinlock_t 경로는 별도입니다.
그림으로 보는 변화
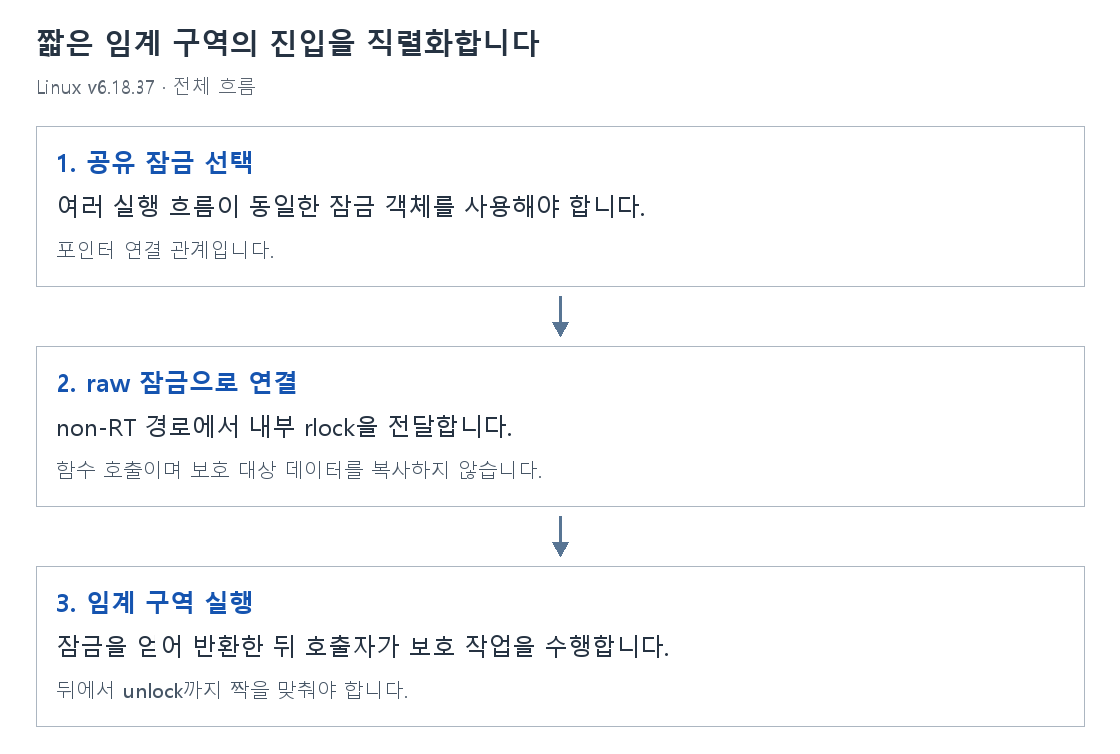
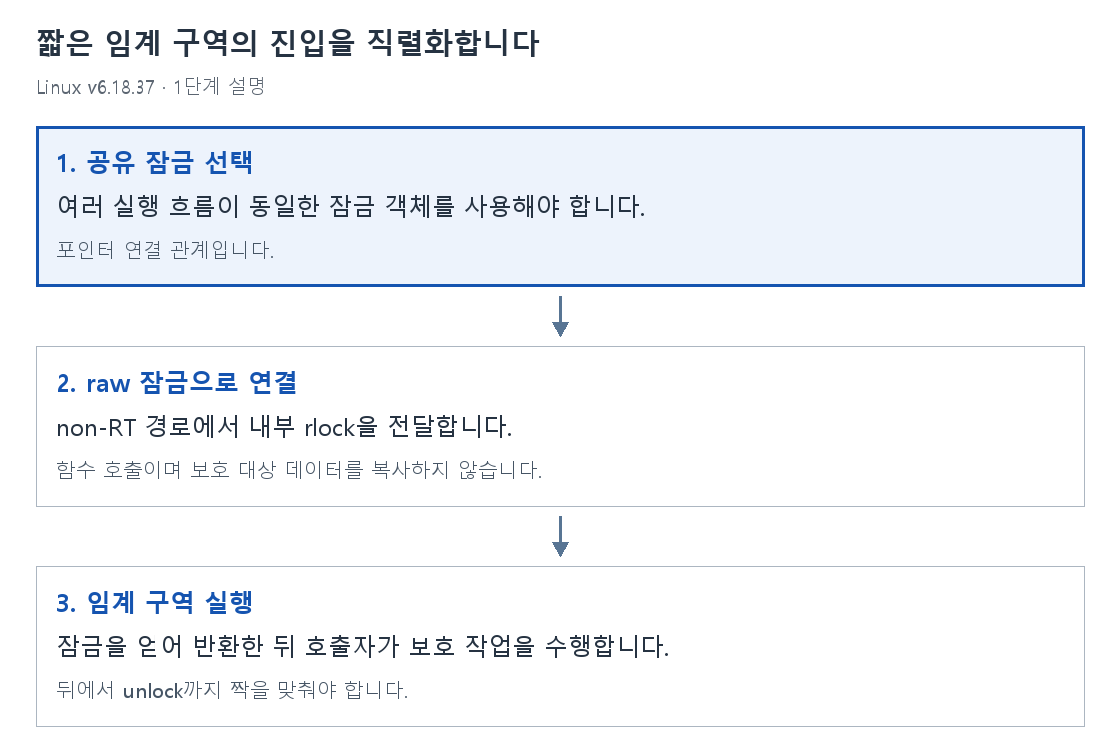
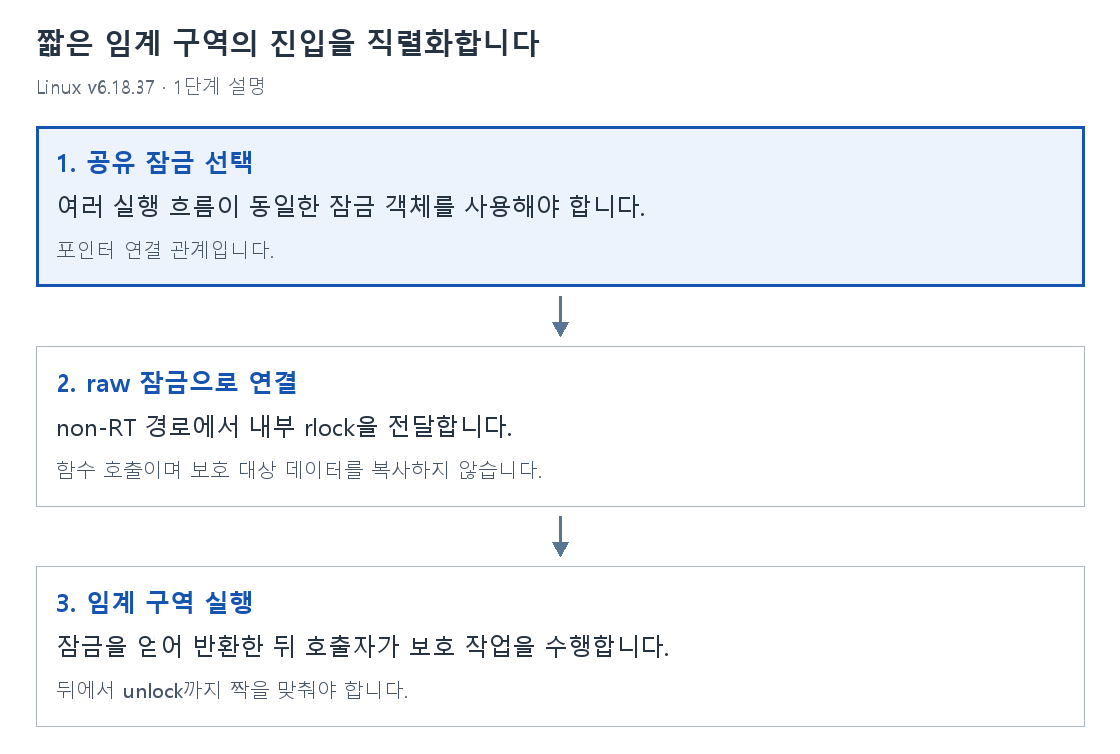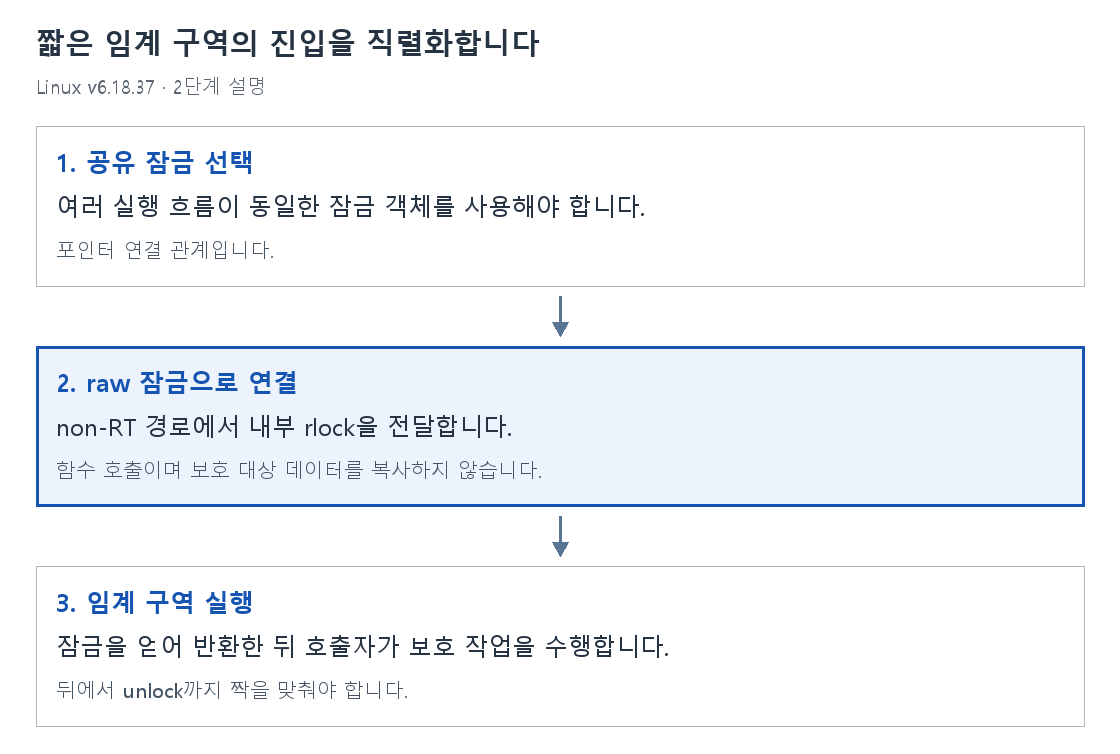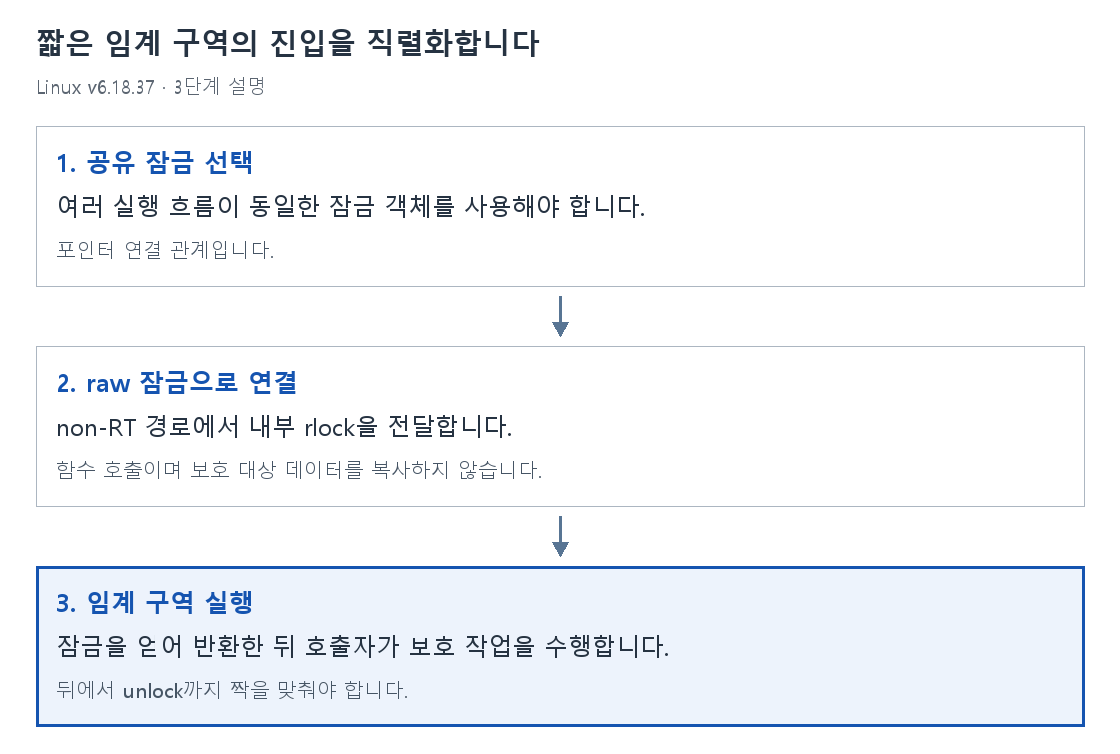
1. 공유 잠금 선택
여러 실행 흐름이 동일한 잠금 객체를 사용해야 합니다.
포인터 연결 관계입니다.
2. raw 잠금으로 연결
non-RT 경로에서 내부 rlock을 전달합니다.
함수 호출이며 보호 대상 데이터를 복사하지 않습니다.
3. 임계 구역 실행
잠금을 얻어 반환한 뒤 호출자가 보호 작업을 수행합니다.
뒤에서 unlock까지 짝을 맞춰야 합니다.
spin_lock를 한 줄씩 읽기
줄 번호는 v6.18.37 원문 기준입니다. 주석·빈 줄을 포함한 함수 전체를 먼저 보고, 그 아래에서 각 줄을 설명합니다.
static __always_inline void spin_lock(spinlock_t *lock)
{
	raw_spin_lock(&lock->rlock);
}static __always_inline void spin_lock(spinlock_t *lock)non-RT 구현의 spinlock_t 잠금을 얻는 래퍼입니다. lock은 보호할 데이터 자체가 아니라 접근 순서를 맞출 잠금 객체이며 __always_inline은 인라인 생성 지시입니다.
raw_spin_lock(&lock->rlock);spinlock_t 안의 raw 잠금 rlock을 전달해 소유권을 얻습니다. 이 non-RT 경로는 선점을 제어하지만 일반 spin_lock 호출이 로컬 IRQ까지 자동 차단하는 것은 아닙니다. 같은 CPU의 IRQ 처리기가 같은 잠금을 사용한다면 IRQ 제어까지 맞춰야 합니다.
함께 생각해 볼 질문
spin_lock이 로컬 IRQ를 무조건 끄나요?
그 효과가 필요한 경우 irq 또는 irqsave 계열과의 차이를 확인해야 합니다.
서로 다른 락을 잡으면 같은 데이터가 보호되나요?
접근자들이 같은 동기화 규칙과 잠금 객체를 공유해야 합니다.
PREEMPT_RT도 이 함수만 보면 되나요?
구성에 따른 타입과 구현 경로가 다르므로 해당 빌드의 헤더 선택을 확인해야 합니다.
출처와 읽은 범위
Linux stable v6.18.37 · include/linux/spinlock.h
해당 버전 원본 파일 · 기존 코드 분석 · 설명 원고