같은 shared library를 사용하는 process가 여러 개 있을 때 각 process의 RSS를 더하면, 실제로는 한 번 존재하는 physical page가 여러 번 계산될 수 있습니다. RSS는 process에 resident mapping된 memory를 나타내지만, 그 memory를 해당 process만 소유한다는 뜻은 아닙니다.
Linux v6.12의 procfs 설명과 fs/proc/task_mmu.c를 기준으로, 빠른 통계와 mapping별 조사 결과를 어떻게 구분해야 하는지 살펴보겠습니다.
status에서 현재값과 최대값을 구분합니다
조회 대상 PID를 정한 뒤 다음 항목을 비교하실 수 있습니다. 다른 process의 상세 정보에는 권한 제한이 적용될 수 있습니다.
cat /proc/self/status
cat /proc/self/smaps_rollup
cat /proc/self/smaps
위 예시의 self는 각 파일을 여는 process 자신입니다. 서로 다른 cat 실행 결과를 동일 process의 연속 측정으로 간주하시면 안 됩니다. 특정 process를 비교하려면 self 대신 같은 PID를 사용하시고, process가 실행 중인 동안 memory 상태가 변한다는 점도 고려해야 합니다.
/proc/PID/status의 VmHWM은 RSS의 high-water mark이며 현재값은 VmRSS입니다. 전자는 실행 중 관찰된 높은 사용량을 나타내므로 현재 RSS가 줄어도 과거의 peak를 표현할 수 있습니다. VmPeak는 virtual size에 관한 다른 항목입니다.
| 항목 | 의미 |
|---|---|
VmRSS |
현재 resident memory 통계이며 RssAnon + RssFile + RssShmem으로 구성됩니다. |
RssAnon |
Anonymous pages의 resident memory입니다. Private file mapping에서 CoW로 생긴 anonymous copy도 포함될 수 있습니다. |
RssFile |
File-backed mapping의 resident memory이며 shmem은 별도 항목으로 계산합니다. |
RssShmem |
Shmem mapping의 resident memory입니다. tmpfs, System V shared memory 등과 연결됩니다. |
VmHWM |
RSS의 high-water mark입니다. |
Virtual address 범위를 확보한 양과 resident memory는 다릅니다. mmap()으로 큰 범위를 만들었어도 아직 접근하지 않은 pages가 모두 RAM에 할당되어 있다는 뜻은 아닙니다. 반대로 shared page는 별도 physical copy 없이도 여러 process의 RSS에 나타날 수 있습니다.
뒤에서 사용할 process A의 관계를 status 형식으로 옮기면 다음과 같습니다. 실측 출력이 아니라 설명용 예시입니다. 현재 RSS는 4 + 8 + 0 = 12 KiB이며, 이전 peak를 16 KiB로 가정했습니다.
VmHWM:         16 kB
VmRSS:         12 kB
RssAnon:        4 kB
RssFile:        8 kB
RssShmem:       0 kB
빠른 RSS counter에는 정밀도 한계가 있습니다
Kernel은 process memory 통계를 조회할 때마다 전체 page table을 조사하지 않고 유지해 둔 counter를 활용할 수 있습니다. 갱신 비용을 줄이는 방식과 동시 실행 때문에, 이런 수치는 상세한 page walk 결과와 정확히 일치하지 않을 수 있습니다.
책에는 thread별 RSS 갱신과 특정 vm_insert_pages() 경로의 지연 집계에 관한 설명이 있습니다. 이때의 구체적인 갱신 방식과 오차 상한은 kernel version에 묶인 구현 사항입니다. 오래된 version의 thread당 오차 공식을 모든 kernel의 보편적 규칙처럼 적용해서는 안 됩니다.
책에서 든 고전 구현의 수치는 TASK_RSS_EVENTS_THRESH = 64 pages입니다. 4 KiB base page이면 thread당 256 KiB에 해당합니다. 또한 책은 zero-copy TCP receive가 사용하는 vm_insert_pages() 경로에서 다음 fault 전까지 집계가 지연될 수 있는 사례를 설명합니다. 이 값과 경로는 당시 counter 구현을 읽는 단서이며, 여기서 사용하는 v6.12나 앞으로의 모든 kernel에 동일한 상한이 유지된다고 주장하는 근거는 아닙니다.
현재 추세를 빠르게 관찰하려면 status가 편리합니다. Mapping별 분해나 PSS가 필요하면 smaps, process 전체 합계가 목적이면 smaps_rollup을 사용하시면 됩니다. stat과 statm도 관련 정보를 제공하지만, 파일 형식과 단위가 다르고 상세한 mapping 분석을 대신하지는 않습니다.
smaps와 smaps_rollup은 무엇이 다른가요
smaps는 VMA별 주소 범위와 접근 권한, backing 정보에 이어 memory 통계를 보여 줍니다. smaps_rollup은 같은 종류의 조사를 process 전체 합계로 묶어 보여 주므로 VMA별 정보가 필요하지 않을 때 출력이 훨씬 간결합니다.
이 경로는 주소 공간을 걸으며 page table과 mapping 상태를 조사합니다. 단순한 counter 읽기보다 비용이 들 수 있습니다. 정밀한 조사를 한다는 이유만으로 실행 중인 process를 시간적으로 완전히 고정한 snapshot이 되는 것은 아니며, 모든 통계의 합이 기계 전체 RAM과 정확히 맞는 것도 아닙니다.
구현으로 내려가면 v6.12의 show_smaps_rollup()이 mmap_lock의 read side를 획득하고 VMA별 smap_gather_stats()를 호출합니다. 이 경로는 walk_page_vma() 또는 이어서 읽는 범위의 walk_page_range()로 page table을 조사하며, smaps_account()에서 resident·PSS·dirty 등의 값을 집계합니다. Lock contention 때는 read lock을 잠시 놓고 다시 획득하는 경로도 있으므로, 출력 전체가 단 한 시점의 변경 불가능한 memory snapshot이라는 설명은 맞지 않습니다.
Shared_Clean, Shared_Dirty, Private_Clean, Private_Dirty는 공유 여부와 dirty 여부를 나눈 통계입니다. Anonymous, AnonHugePages, ShmemPmdMapped, FilePmdMapped처럼 backing이나 mapping 크기를 설명하는 항목도 함께 볼 수 있습니다. 이 항목들은 서로 배타적인 분류표의 모든 칸이 아니므로, 화면에 보이는 모든 값을 더해서 RSS를 재구성하려 해서는 안 됩니다.
여기서 shared/private는 maps의 s/p나 MAP_SHARED/MAP_PRIVATE와 같은 분류가 아닙니다. 일반적인 present base page에서는 실제 mapping의 공유 정도가 관여합니다. MAP_SHARED file page도 현재 mapping이 하나라면 Private_*로 계산될 수 있고, MAP_PRIVATE file mapping의 아직 CoW하지 않은 page가 여러 mapping에 연결되어 있다면 Shared_*로 보일 수 있습니다.
Clean/dirty 분류는 해당 PTE와 folio의 dirty 상태를 함께 반영합니다. 이 기준 역시 VMA가 쓰기 가능한지와 같은 질문은 아닙니다. Large folio나 migration entry 등에는 별도 집계 경로가 있으므로 이 base-page 예시를 모든 상태의 단일 판정식으로 일반화하지 않아야 합니다.
Swap은 현재 RAM 밖으로 나간 mapping 관련 통계이고 SwapPss는 공유를 비례 배분한 항목입니다. Locked는 memory locking과 연결됩니다. HugeTLB와 large folio의 집계에는 별도 의미와 구현상 세부 조건이 있으므로 base-page 예시를 그대로 확장해서 해석하지 않으시는 편이 좋습니다.
PSS는 공유분을 mapping 수에 따라 나눕니다
Proportional Set Size는 공유 page의 비용을 각 mapping에 비례 배분하는 통계입니다. 단순한 base-page 예시에서 4 KiB page를 두 mapping이 공유하면 각 mapping은 PSS에 2 KiB씩 기여합니다. 분모는 단순히 process 개수라고만 생각하시면 안 됩니다. 같은 process가 같은 page를 여러 번 mapping할 수도 있습니다.
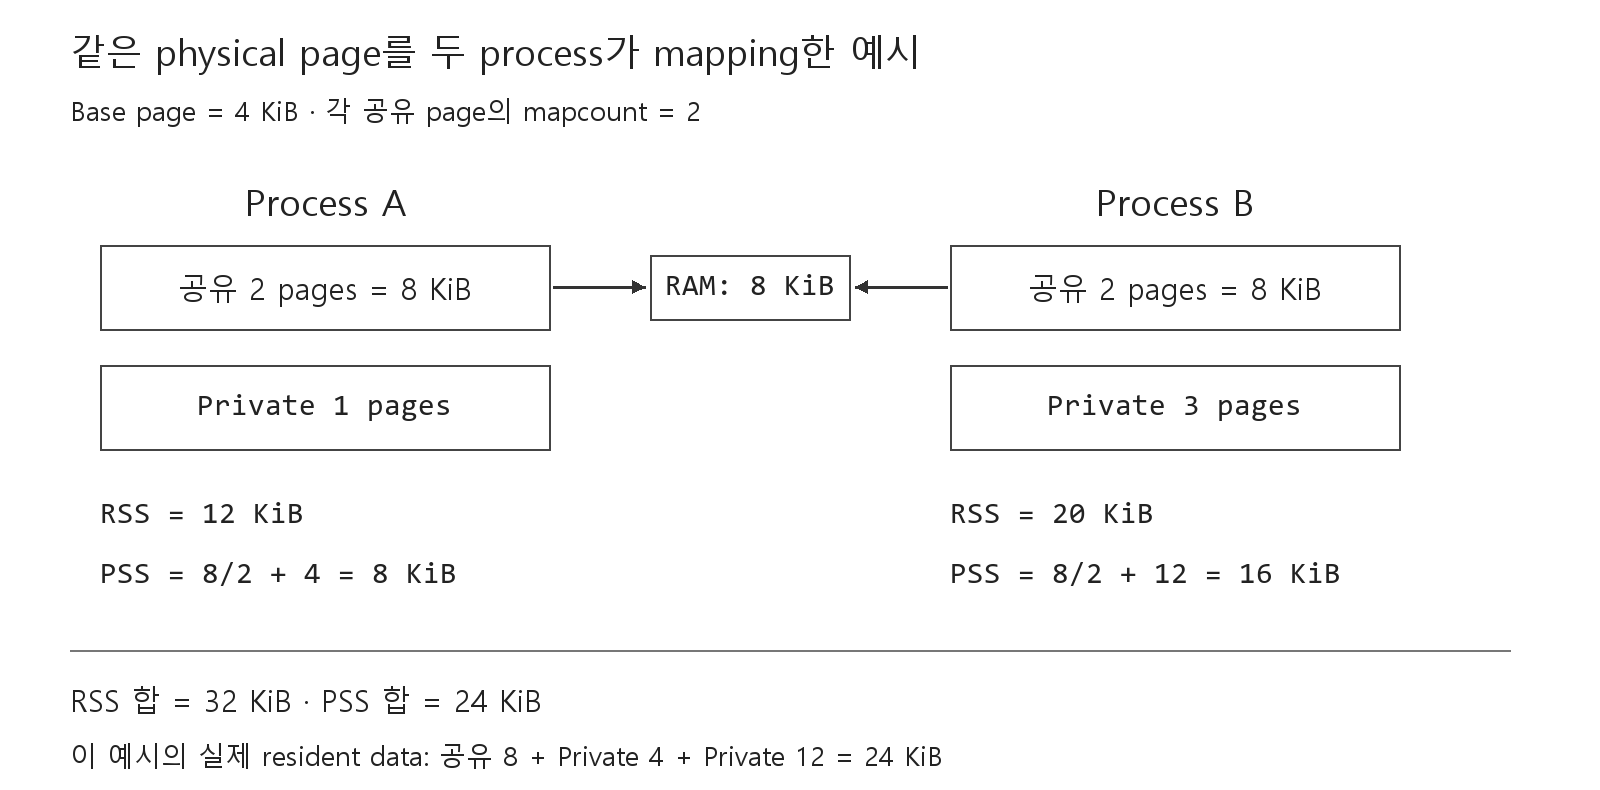
그림에서 공유 memory는 8 KiB입니다. A의 private memory는 4 KiB, B의 private memory는 12 KiB이므로 두 process의 RSS는 각각 12 KiB와 20 KiB입니다. 합계 32 KiB에는 공유 8 KiB가 두 번 들어 있습니다.
이 예시의 공유 page들은 mapcount가 2이므로 PSS에서는 A와 B에 각각 4 KiB를 배분합니다. 따라서 A의 PSS는 8 KiB, B의 PSS는 16 KiB이고 합계는 24 KiB입니다. 예시에서 실제 resident data인 공유 8 KiB와 private 16 KiB의 합과 같습니다.
그렇다고 일반적인 시스템에서 모든 process의 PSS를 더한 값이 MemTotal - MemFree가 된다는 뜻은 아닙니다. Kernel memory, process에 mapping되지 않은 page cache와 조사 중 상태 변화 등 다른 요인이 남습니다. PSS는 process 간 공유 비용을 해석하는 도구이지 시스템의 모든 memory를 빠짐없이 분배한 회계표는 아닙니다.
Migration entry처럼 일반적인 present mapping이 아닌 상태에도 별도 처리가 있습니다. Linux v6.12의 smaps_account()는 이런 상황에서 안정적으로 읽을 수 없는 mapcount를 그대로 신뢰하지 않고 별도의 집계 경로를 사용합니다. 이를 실제 page의 mapcount가 영구적으로 1로 바뀌었다는 의미로 이해해서는 안 됩니다.
그림의 A에서 private 4 KiB가 dirty anonymous memory이고, 공유한 8 KiB가 clean file memory라고 가정해 보겠습니다. 아래는 이 관계에 맞추어 만든 설명용 출력 예시이며 실제 측정 결과가 아닙니다. Hugetlb·swap·locking은 없고, 모든 resident page를 referenced로 가정했습니다.
10000000-10009000 ---p 00000000 00:00 0 [rollup]
Rss:                  12 kB
Pss:                   8 kB
Pss_Dirty:             4 kB
Pss_Anon:              4 kB
Pss_File:              4 kB
Pss_Shmem:             0 kB
Shared_Clean:          8 kB
Shared_Dirty:          0 kB
Private_Clean:         0 kB
Private_Dirty:         4 kB
Referenced:           12 kB
Anonymous:             4 kB
KSM:                   0 kB
LazyFree:              0 kB
AnonHugePages:         0 kB
ShmemPmdMapped:        0 kB
FilePmdMapped:         0 kB
Shared_Hugetlb:        0 kB
Private_Hugetlb:       0 kB
Swap:                  0 kB
SwapPss:               0 kB
Locked:                0 kB
RSS 12 KiB는 shared 8 KiB와 private 4 KiB의 합입니다. PSS에서는 공유분을 절반만 배분하므로 8 KiB가 됩니다. 그중 anonymous 4 KiB는 전부 이 process의 비용이고, file 쪽 4 KiB는 공유한 8 KiB의 절반입니다. Header의 시작·끝 주소 사이에는 resident하지 않은 범위나 VMA 사이의 빈틈도 있을 수 있으므로, 두 주소를 뺀 길이를 RSS라고 읽으시면 안 됩니다.
Dirty, referenced와 swap에는 별도 집계 기준이 있습니다
Pss_Dirty는 PSS 중 dirty pages가 기여한 부분입니다. 일반적인 present page에서는 공유분을 나누는 기준과 dirty 판정을 함께 적용합니다. VMA가 writable하다는 사실만으로 범위 전체가 dirty인 것은 아닙니다.
Private_Dirty라는 통계 이름만 보고 “이 memory는 절대로 writeback할 수 없다”고 결론을 내리셔도 안 됩니다. 현재 mapping이 하나인 MAP_SHARED file page도 private 통계로 분류될 수 있습니다. 반면 private file mapping에서 CoW한 anonymous copy는 원래 file에 writeback하는 대상이 아닙니다. 통계상의 private와 mapping의 MAP_PRIVATE를 구분해야 하는 이유입니다.
Referenced는 page의 referenced 상태와 PTE의 accessed/young 상태 등을 관찰한 값입니다. Architecture의 _PAGE_ACCESSED, pte_young()과 folio의 referenced 상태를 따라가면 집계 기준을 이해할 수 있습니다. 실제로 마지막 몇 초 동안 접근한 byte를 모두 기록한 값이나, 이후 reclaim에서 절대로 회수하지 않을 memory의 크기는 아닙니다.
Swap은 anonymous swap뿐 아니라, shmem mapping에서 CoW로 대체되지 않은 범위에 해당하는 underlying object의 swap도 포함할 수 있습니다. 그런데 SwapPss는 같은 shmem object의 swapped-out pages를 이 방식으로 포함하지 않습니다. 따라서 두 필드의 차이를 단순히 공유 비율의 차이로만 설명하시면 안 됩니다.
Locked에도 공유분을 비례 배분하는 집계가 적용됩니다. 이를 /proc/PID/status의 VmLck나 locking된 VMA의 길이와 무조건 일치시켜서는 안 됩니다. Shared_Hugetlb와 Private_Hugetlb 역시 역사적인 이유로 일반 RSS/PSS 및 clean/dirty 합계와 별도로 다루므로, 보이는 모든 행을 한 총합에 더하지 않는 것이 중요합니다.
어떤 수치를 먼저 볼까요
현재와 peak를 빠르게 보려면 VmRSS와 VmHWM부터 확인하시면 됩니다. 공유 memory 때문에 합계가 부풀어 보이거나 process별 비용을 비교하려는 목적이라면 PSS를 보시는 편이 적합합니다. 특정 file mapping이나 anonymous 영역이 증가하는 위치를 찾으려면 smaps에서 VMA별로 내려가시면 됩니다.
수치 하나를 정확한 답으로 고르기보다, 같은 PID·같은 단위·비슷한 시점의 결과인지 먼저 확인하는 것이 중요합니다. Memory를 얼마나 예약했는지, 얼마나 resident인지, 얼마나 공유하고 있는지는 서로 다른 질문입니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access edition, 2025, §14.2 및 §14.5.2.
- Linux v6.12
/procdocumentation - Linux v6.12
fs/proc/task_mmu.c