mmap으로 파일을 읽을 때 cache hit은 반가운 소식이지만 fault의 완료 조건은 아닙니다. 찾은 folio가 아직 읽히는 중일 수도 있고, lock을 기다리는 사이 파일이 줄어들 수도 있으며, I/O를 위해 fault lock을 놓았다면 원래 VMA가 사라졌을 수도 있습니다. filemap_fault()는 이 서로 다른 수명을 맞춘 뒤에야 page를 generic fault handler에 넘깁니다.
여기서는 upstream Linux v6.18의 generic file-backed read fault를 기준으로 설명합니다. filesystem별 전용 fault, DAX, write fault와 private CoW 전체를 하나의 경로로 합치지는 않습니다.
read의 byte count 대신 fault 결과와 page를 돌려줍니다
read()는 user buffer에 복사한 양을 반환합니다. 반면 file-backed fault는 VMA의 fault 주소에 연결할 page를 준비하고 vm_fault_t 결과로 성공·재시도·오류를 전달합니다. struct vm_fault에는 VMA, file index, fault flag와 최종 page 같은 상태가 이어집니다.
VMA의 vm_operations_struct.fault가 filesystem의 진입점이며 많은 filesystem이 generic filemap_fault()를 재사용합니다. 공통 page cache를 찾는다는 점은 read와 같지만, fault lock과 VMA 재검증, SIGBUS 판정, subpage 선택 때문에 완전히 같은 함수로 합쳐지지는 않습니다.
file index는 vmf->pgoff에서 얻으며 fault의 virtual address 자체가 아닙니다. file은 vmf->vma->vm_file, mapping은 그 file의 f_mapping, inode는 mapping의 host를 통해 찾습니다. 함수가 처음부터 추가 file 참조나 invalidate lock을 가진 것은 아니므로 fpin은 NULL, mapping_locked는 false로 시작합니다. 누적 결과 flag인 ret와 이 두 수명 상태를 따로 추적해야 오류 뒤에도 같은 cleanup을 기계적으로 적용하는 실수를 피할 수 있습니다.
처음에는 파일 크기를 page 단위로 올림한 exclusive index를 구합니다. fault index가 이 범위 밖이면 VM_FAULT_SIGBUS입니다. 마지막 일부 page는 존재하되 EOF 뒤의 byte를 zero로 다루는 문제와, 마지막 page 자체를 벗어난 접근은 다릅니다. VMA가 충분히 길다고 backing file에도 그 범위가 생기는 것은 아닙니다.
SIGBUS는 VMA의 존재만으로 피할 수 없습니다
매핑되지 않은 주소나 허용되지 않은 접근에서 발생하는 SIGSEGV와, 파일 mapping 안에 있지만 backing 내용이 없는 접근의 SIGBUS를 구별하면 문제를 진단하기 쉽습니다. 다만 모든 architecture의 fault를 두 문장짜리 보편 분류로 환원해서는 안 됩니다.
예를 들어 mmap 뒤 다른 thread가 파일을 줄이면 VMA의 길이는 남아 있어도 잘린 file page에 대한 접근은 해결할 수 없습니다. 저장장치나 network filesystem의 read가 복구할 수 없는 오류로 끝나는 경우에도 fault는 SIGBUS 결과로 이어질 수 있습니다. read()였다면 음수 errno나 short read로 관찰할 문제를 memory access에서는 fault 결과와 signal로 전달하는 것입니다.
SIGBUS가 파일의 EOF만을 나타내는 signal이라는 뜻도 아닙니다. 일부 architecture에서 허용하지 않는 unaligned access 역시 SIGBUS의 원인이 될 수 있습니다. 여기서 설명하는 것은 그중 generic file-backed fault의 backing file·I/O 조건입니다.
파일 끝과 partial page의 user interface는 mmap(2), fault의 실제 결과 분기는 filemap_fault()를 함께 보아야 합니다. 유효한 virtual address라는 사실만으로 storage access의 성공까지 보장되지는 않습니다.
cache miss는 readahead를 시도할 출발점입니다
cache lookup에서 folio를 찾으면 불필요한 중복 trigger를 피하기 위해 FAULT_FLAG_TRIED 등을 고려하며 asynchronous readahead 기회를 검사합니다. 하지만 folio가 not-uptodate이면 바로 반환하지 않습니다. 진행 중 read, invalidation, 이전 실패나 아직 내용이 채워지지 않은 allocation을 구별할 필요가 있습니다.
cache miss에서는 major-fault 관련 accounting과 synchronous mmap readahead를 거쳐 필요한 데이터가 준비될 기회를 만듭니다. 여기서 synchronous라는 말은 readahead가 window 전체의 storage I/O를 모두 끝낸 뒤에만 돌아온다는 뜻이 아닙니다. demand fault가 필요한 folio의 완료를 기다리는 단계와 window를 미리 준비하는 단계가 나뉩니다.
random VMA나 readahead 비활성 정책 때문에 추측을 하지 않을 수도 있습니다. 이 경우에도 지금 fault를 해결할 folio는 필요합니다. FGP_CREAT | FGP_FOR_MMAP을 사용한 lookup·allocation 경로가 기존 folio를 다시 찾거나 새 not-uptodate folio를 cache에 넣고, 뒤의 단일 read가 그 내용을 채울 수 있습니다.
따라서 readahead가 원하는 결과를 만들지 못했다는 사실을 곧바로 fault 실패로 해석하면 안 됩니다. 반대로 allocation이 성공해 folio가 생겼다는 사실도 storage 내용이 유효하다는 의미는 아닙니다.
필요한 folio를 얻는 allocation까지 실패한 경우도 구별해야 합니다. v6.18의 __filemap_get_folio() 실패 표현은 ERR_PTR이며 IS_ERR()로 검사합니다. 오래된 NULL 중심 예시를 그대로 옮겨 if (!folio)만 확인하면 error pointer를 실제 folio처럼 사용할 수 있습니다. 해당 fault 경로는 이미 fpin을 얻어 fault lock을 놓았다면 retry cleanup으로 돌아가고, 그렇지 않다면 shared invalidate lock을 놓고 VM_FAULT_OOM을 반환합니다. allocation 실패와 파일 범위 오류의 VM_FAULT_SIGBUS는 다른 결과입니다. 실패 분기 전체
invalidate lock과 folio lock은 다른 범위를 보호합니다
mapping의 shared invalidate lock은 cache를 채우는 경로와 filesystem의 invalidation·block mapping 변경 사이의 경쟁을 다룹니다. mapping_locked 같은 상태는 이 lock을 이미 얻었는지 추적해 retry와 cleanup에서 맞게 풀도록 합니다.
folio lock은 선택한 folio의 상태와 mapping 재검사를 직렬화합니다. reader가 lookup 참조를 얻은 뒤에도 truncate는 그 folio를 cache에서 떼어 낼 수 있습니다. 따라서 lock을 얻은 다음 folio->mapping이 기대한 mapping과 같은지 검사합니다. 다르면 unlock과 put을 한 뒤 lookup부터 다시 시작합니다.
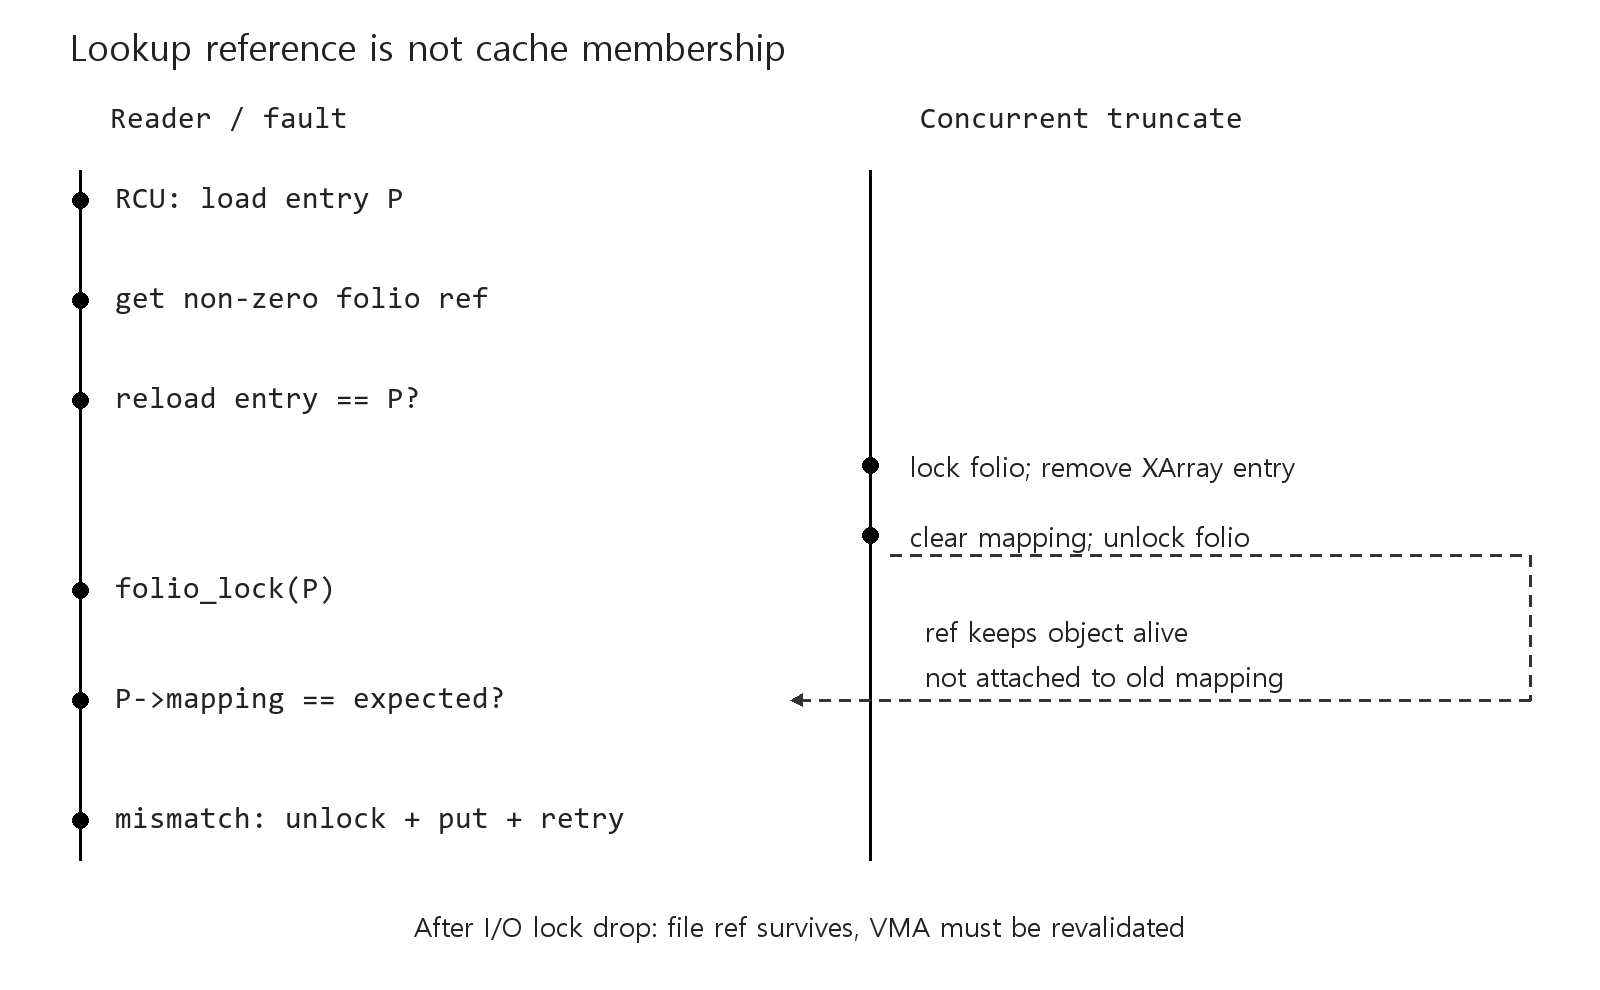
여기에 folio_contains() 같은 debug 검사는 index와 folio 범위의 일관성을 확인합니다. debug assertion이 있다는 이유로 release build에서 caller가 범위와 소속 조건을 무시해도 되는 것은 아닙니다. large folio라면 마지막에 반환할 subpage와 folio 전체의 index 범위를 나누어 생각해야 합니다.
file을 살려 두는 fpin은 VMA를 살려 두지 않습니다
느린 I/O를 기다리는 동안 mmap 관련 read lock을 계속 잡으면 다른 thread의 VMA 변경이 오래 막힐 수 있습니다. maybe_unlock_mmap_for_io() 계열은 허용된 조건에서 fault lock을 놓고, 대신 get_file()로 얻은 참조를 fpin에 남깁니다.
이 참조는 열린 file 객체의 수명을 유지합니다. 원래 virtual address 범위와 permission이 그대로라는 보장은 아닙니다. 다른 thread가 unmap하거나 mapping을 교체한 뒤 storage read만 끝났을 수도 있습니다. 따라서 folio 내용이 준비되었더라도 lock을 놓았던 fault는 VM_FAULT_RETRY로 바깥 handler에 돌아가 VMA와 접근 조건을 다시 확인해야 합니다.
folio의 참조도 따로 세어야 합니다. filemap_add_folio()로 cache에 성공적으로 삽입한 folio에는 page cache가 보유하는 참조와 caller의 참조가 있습니다. fault cleanup의 folio_put() 하나가 언제나 folio를 즉시 free하는 것은 아닙니다. truncate가 cache 참조를 먼저 제거했는지, 다른 lookup이나 mapping이 참조하는지에 따라 최종 해제 시점이 달라집니다. file의 f_count, folio의 refcount와 VMA 수명은 서로 바꾸어 셀 수 없습니다.
현재의 lock_folio_maybe_drop_mmap()은 먼저 trylock하고, 필요하면 fault lock을 놓거나 killable 대기를 수행합니다. FAULT_FLAG_RETRY_NOWAIT이면 folio lock을 얻지 못했을 때 fault lock을 유지한 채 RETRY 결과를 만드는 예외가 있습니다. per-VMA lock 경로도 있으므로 RETRY bit 하나만 보고 어떤 lock이 반드시 풀렸다고 결론 내려서는 안 됩니다.
이는 오류 처리에서 특히 중요합니다. 재시도용 cleanup은 folio 참조, 필요하면 invalidate lock, fpin의 file 참조를 각각 정리합니다. lock을 놓은 사실을 잊고 이전 VMA를 계속 사용하거나, retry라는 이유로 얻었던 참조를 남기면 다른 종류의 수명 오류가 됩니다.
not-uptodate folio는 직접 읽고 다시 검증합니다
lock을 얻었는데 내용이 유효하지 않으면, invalidation과의 직렬화가 확보되었는지 확인한 뒤 filemap_read_folio()로 직접 read를 시도합니다. callback의 제출 성공과 folio의 I/O 완료는 다른 사건이므로 unlock을 기다린 뒤 uptodate를 확인합니다.
read 동안 fault lock을 놓았다면 read의 성공·실패와 무관하게 원래 VMA를 믿고 진행할 수 없습니다. 먼저 바깥 fault로 돌아가야 합니다. 반면 필요한 lock을 계속 유지한 경우에는 truncation에 의한 재시도 조건과 복구할 수 없는 I/O 오류를 구별합니다. 후자는 SIGBUS 결과로 이어질 수 있습니다.
folio를 준비하는 과정에서 기다렸으므로 마지막 EOF 검사도 필요합니다. 처음에는 범위 안이었지만 그 뒤 파일이 줄었을 수 있기 때문입니다. 지금의 파일 크기를 벗어났다면 folio를 unlock하고 참조를 놓습니다. 범위 안이고 내용과 mapping도 맞는 경우에야 folio_file_page()로 해당 subpage를 골라 vmf->page에 넣습니다.
성공 결과인 VM_FAULT_LOCKED는 folio lock을 유지한 채 generic caller가 후속 처리를 이어받는다는 표시입니다. 단순히 함수가 끝났으니 이곳에서 모든 lock과 참조를 해제해야 하는 일반 함수 반환과는 다릅니다. 결과 flag가 소유권 계약의 일부입니다.
또한 이 함수는 retry 결과에 VM_FAULT_ERROR 계열 bit를 함께 실어 최종 오류까지 확정하지 않습니다. lock을 놓아 원래 VMA를 다시 검증해야 하는 상태와, 현재 유효한 fault 문맥에서 오류를 확정한 상태를 분리하기 때문입니다. caller도 반환 bit와 lock 상태의 계약을 함께 따라야 합니다.
전체 함수에서 cleanup의 순서를 확인합니다
다음은 v6.18 filemap_fault()의 전체 정의입니다. GPL-2.0-only와 source attribution을 파일에 보존했습니다. kernel 내부 helper에 의존하는 발췌이며 standalone program은 아닙니다. 앞서 설명한 branch를 같은 함수 안에서 연결해 읽기 위한 code입니다.
현재 cache miss 분기에는 major accounting보다 앞선 filemap_fault_recheck_pte_none() 검사도 있습니다. VM_LOCKED이고 원래 PTE가 유효했던 특수 문맥에서 PTE가 일시적으로 비어 보인 상황을 다시 확인합니다. 모든 cache miss에 무조건 PTE lock을 잡는 검사는 아닙니다. 따라서 첫 cache lookup이 실패했다는 사실만으로 바로 major-fault 경로가 끝까지 실행된다고 가정하면 안 됩니다. out_retry는 유효한 folio 참조만 놓고, mapping_locked일 때만 invalidate lock을 놓으며, fpin이 있을 때만 file 참조를 정리합니다. page_not_uptodate에서 AOP_TRUNCATED_PAGE는 재검색을 위한 제어 결과이지 영구 storage 오류가 아닙니다.
// SPDX-License-Identifier: GPL-2.0-only
/*
 * Complete definition from Linux v6.18 mm/filemap.c.
 * Source: https://github.com/torvalds/linux/blob/v6.18/mm/filemap.c
 * File-cache code: Copyright (C) 1994-1999 Linus Torvalds
 * Kernel excerpt; not a standalone user-space program.
 */

vm_fault_t filemap_fault(struct vm_fault *vmf)
{
	int error;
	struct file *file = vmf->vma->vm_file;
	struct file *fpin = NULL;
	struct address_space *mapping = file->f_mapping;
	struct inode *inode = mapping->host;
	pgoff_t max_idx, index = vmf->pgoff;
	struct folio *folio;
	vm_fault_t ret = 0;
	bool mapping_locked = false;

	max_idx = DIV_ROUND_UP(i_size_read(inode), PAGE_SIZE);
	if (unlikely(index >= max_idx))
		return VM_FAULT_SIGBUS;

	trace_mm_filemap_fault(mapping, index);

	/*
	 * Do we have something in the page cache already?
	 */
	folio = filemap_get_folio(mapping, index);
	if (likely(!IS_ERR(folio))) {
		/*
		 * We found the page, so try async readahead before waiting for
		 * the lock.
		 */
		if (!(vmf->flags & FAULT_FLAG_TRIED))
			fpin = do_async_mmap_readahead(vmf, folio);
		if (unlikely(!folio_test_uptodate(folio))) {
			filemap_invalidate_lock_shared(mapping);
			mapping_locked = true;
		}
	} else {
		ret = filemap_fault_recheck_pte_none(vmf);
		if (unlikely(ret))
			return ret;

		/* No page in the page cache at all */
		count_vm_event(PGMAJFAULT);
		count_memcg_event_mm(vmf->vma->vm_mm, PGMAJFAULT);
		ret = VM_FAULT_MAJOR;
		fpin = do_sync_mmap_readahead(vmf);
retry_find:
		/*
		 * See comment in filemap_create_folio() why we need
		 * invalidate_lock
		 */
		if (!mapping_locked) {
			filemap_invalidate_lock_shared(mapping);
			mapping_locked = true;
		}
		folio = __filemap_get_folio(mapping, index,
					  FGP_CREAT|FGP_FOR_MMAP,
					  vmf->gfp_mask);
		if (IS_ERR(folio)) {
			if (fpin)
				goto out_retry;
			filemap_invalidate_unlock_shared(mapping);
			return VM_FAULT_OOM;
		}
	}

	if (!lock_folio_maybe_drop_mmap(vmf, folio, &fpin))
		goto out_retry;

	/* Did it get truncated? */
	if (unlikely(folio->mapping != mapping)) {
		folio_unlock(folio);
		folio_put(folio);
		goto retry_find;
	}
	VM_BUG_ON_FOLIO(!folio_contains(folio, index), folio);

	/*
	 * We have a locked folio in the page cache, now we need to check
	 * that it's up-to-date. If not, it is going to be due to an error,
	 * or because readahead was otherwise unable to retrieve it.
	 */
	if (unlikely(!folio_test_uptodate(folio))) {
		/*
		 * If the invalidate lock is not held, the folio was in cache
		 * and uptodate and now it is not. Strange but possible since we
		 * didn't hold the page lock all the time. Let's drop
		 * everything, get the invalidate lock and try again.
		 */
		if (!mapping_locked) {
			folio_unlock(folio);
			folio_put(folio);
			goto retry_find;
		}

		/*
		 * OK, the folio is really not uptodate. This can be because the
		 * VMA has the VM_RAND_READ flag set, or because an error
		 * arose. Let's read it in directly.
		 */
		goto page_not_uptodate;
	}

	/*
	 * We've made it this far and we had to drop our mmap_lock, now is the
	 * time to return to the upper layer and have it re-find the vma and
	 * redo the fault.
	 */
	if (fpin) {
		folio_unlock(folio);
		goto out_retry;
	}
	if (mapping_locked)
		filemap_invalidate_unlock_shared(mapping);

	/*
	 * Found the page and have a reference on it.
	 * We must recheck i_size under page lock.
	 */
	max_idx = DIV_ROUND_UP(i_size_read(inode), PAGE_SIZE);
	if (unlikely(index >= max_idx)) {
		folio_unlock(folio);
		folio_put(folio);
		return VM_FAULT_SIGBUS;
	}

	vmf->page = folio_file_page(folio, index);
	return ret | VM_FAULT_LOCKED;

page_not_uptodate:
	/*
	 * Umm, take care of errors if the page isn't up-to-date.
	 * Try to re-read it _once_. We do this synchronously,
	 * because there really aren't any performance issues here
	 * and we need to check for errors.
	 */
	fpin = maybe_unlock_mmap_for_io(vmf, fpin);
	error = filemap_read_folio(file, mapping->a_ops->read_folio, folio);
	if (fpin)
		goto out_retry;
	folio_put(folio);

	if (!error || error == AOP_TRUNCATED_PAGE)
		goto retry_find;
	filemap_invalidate_unlock_shared(mapping);

	return VM_FAULT_SIGBUS;

out_retry:
	/*
	 * We dropped the mmap_lock, we need to return to the fault handler to
	 * re-find the vma and come back and find our hopefully still populated
	 * page.
	 */
	if (!IS_ERR(folio))
		folio_put(folio);
	if (mapping_locked)
		filemap_invalidate_unlock_shared(mapping);
	if (fpin)
		fput(fpin);
	return ret | VM_FAULT_RETRY;
}
major와 minor를 disk read 횟수로 읽지 않습니다
cache miss와 storage I/O가 관련 있다고 해서 major fault 하나가 BIO 하나와 대응하는 것은 아닙니다. readahead가 여러 folio를 읽을 수 있고, concurrent reader가 먼저 데이터를 준비할 수도 있으며, fault가 retry될 수도 있습니다.
system의 /proc/vmstat counter, task의 min_flt·maj_flt, perf의 event는 관찰 지점과 성공·실패를 처리하는 규칙이 같지 않습니다. v6.18의 mm_account_fault()는 RETRY 중간 결과를 곧바로 task 완료 횟수에 넣지 않고, 최종 성공에 VM_FAULT_MAJOR나 FAULT_FLAG_TRIED가 있는지도 봅니다. 따라서 서로 다른 counter의 숫자가 같아야 한다는 기대부터 내려놓아야 합니다. fault accounting
구체적으로 /proc/vmstat의 이름은 pgfault와 pgmajfault입니다. task 통계는 /proc/PID/stat이나 getrusage()로 볼 수 있고, 같은 시간 범위를 측정하지 않으면 둘을 비교하는 것부터 어긋납니다. fault가 readahead를 통해 여러 folio를 준비해도 major counter가 그 folio 수만큼 늘어나는 것은 아닙니다. generic filemap 경로의 major 판정에는 system event와 memcg event 갱신도 있으며, task 쪽 최종 accounting과는 위치가 다릅니다. 따라서 서로 다른 집계의 숫자를 섞어 빼서 minor fault 횟수라고 부르면 안 됩니다.
file-backed fault를 읽을 때에는 세 질문을 따로 묻는 것이 좋습니다. folio 객체를 사용할 참조가 있는지, 아직 같은 파일의 내용인지, 그 내용을 이 VMA에 연결할 권한이 여전히 있는지입니다. cache hit 뒤의 재시도는 이 검사를 생략하지 않기 위한 정상적인 경쟁 처리입니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 9, §9.4.
- Linux v6.18: filemap_fault와 lock helper, generic fault와 accounting.
- mmap(2), munmap(2).