같은 파일을 두 process가 읽는다고 해서 저장장치의 같은 내용을 RAM에 두 번 가져올 필요는 없습니다. 각자가 파일 어디까지 읽었는지는 달라도 파일의 같은 offset에서 찾는 데이터는 공유할 수 있습니다. Linux의 page cache를 이해하는 출발점은 이처럼 열린 파일의 상태와 파일 데이터의 소유자를 구별하는 일입니다.
이 글은 일반적인 buffered file access를 다룹니다. direct I/O와 DAX처럼 page cache를 우회하는 경로까지 같은 설명으로 묶지는 않습니다. 객체 관계와 초기화의 구체적인 이름은 upstream Linux v6.18 source와 대조합니다. 이 tag는 책의 모든 Listing이 나온 build나 WSL의 6.18.33.2와 같다는 뜻이 아닙니다.
cache는 재사용 공간이자 I/O buffer입니다
저장장치에서 읽어 온 byte를 user buffer로 옮기려면 kernel에도 그 내용을 받아 둘 공간이 필요합니다. page cache의 folio는 이 I/O buffer이면서, 다음 접근이 같은 데이터를 재사용할 수 있는 보관 장소입니다. cache hit은 저장장치 접근을 생략할 기회를 주고, cache miss는 필요한 folio를 준비하고 내용을 읽는 작업으로 이어집니다.
그렇다고 cache에 pointer가 있다는 사실만으로 모든 준비가 끝난 것은 아닙니다. 다른 reader가 만들어 놓은 folio의 I/O가 아직 진행 중일 수 있습니다. folio의 존재, 내용의 유효성인 uptodate, 현재 mapping에 대한 소속은 각각 확인할 조건입니다. 데이터가 RAM에 있더라도 process의 page table에는 PTE가 없을 수 있어 mmap 접근은 별도의 fault를 거칩니다.
쓰기에서는 즉시 저장하지 않아도 변경을 잊지 않는 일이 더 중요합니다. cache에 반영된 변경을 dirty로 추적하고, 나중에 writeback이 그 책임을 이어받습니다. shared mmap에서는 MMU의 write protection과 fault를 이용해 새 쓰기를 포착할 수 있습니다. 다만 dirty를 지우는 시점, I/O가 끝나는 시점, filesystem이 durability를 보장하는 시점은 하나가 아닙니다.
다시 쓰기를 포착하려면 folio flag만 지워서는 부족합니다. 이미 writable인 shared PTE를 통해 CPU가 계속 쓸 수 있기 때문입니다. writeback을 준비하는 folio_clear_dirty_for_io()는 필요한 mapping에서 reverse mapping을 따라가는 folio_mkclean()을 사용해 PTE의 dirty·write 권한을 정리합니다. 이후의 store가 다시 fault를 거쳐 dirty로 추적되도록 하는 절차입니다. 이는 I/O가 성공한 뒤에만 write protection을 복원한다는 뜻이 아닙니다. dirty 전환의 전체 구현
RAM-backed filesystem에는 영구 block device로 기록하는 모델을 그대로 적용할 수 없습니다. tmpfs의 내용은 swap과 관계가 있을 수 있지만 일반적인 disk-backed file writeback과 같은 경로는 아닙니다. filesystem의 address_space_operations가 어떤 동작을 제공하는지를 함께 보아야 합니다.
inode는 파일을 나타내고 file은 열린 상태를 나타냅니다
struct inode는 파일의 metadata와 filesystem 안에서의 식별을 담습니다. directory도 inode를 갖습니다. inode number는 filesystem의 문맥과 함께 해석해야 하므로, 서로 다른 mounted filesystem에서 같은 번호가 보였다는 이유만으로 같은 파일이라고 결론 내릴 수는 없습니다.
번호 자체는 i_ino에 들어가며 ls -i로도 관찰할 수 있습니다. 이름의 i를 index로 풀이하는 관습과는 별개로, 이 번호가 process의 fd나 파일 내 byte offset을 뜻하지 않는다는 점이 중요합니다.
process가 보통 사용하는 것은 inode pointer가 아니라 open() 등으로 얻은 file descriptor입니다. fd는 descriptor table의 번호이며 그 entry가 struct file을 가리킵니다. struct file에는 f_inode, f_pos, f_mode와 경로 같은 열린 상태가 있습니다. 라이브러리의 fopen()이 buffering을 덧붙여도 kernel에 전달되는 열린 파일의 구별은 남습니다.
같은 파일을 별도로 두 번 열면 일반적으로 struct file도 두 개입니다. 반면 dup()이나 fork()로 공유한 descriptor는 같은 open file description을 가리킬 수 있습니다. 따라서 서로 다른 fd라는 사실만으로 position까지 독립적이라고 가정하면 안 됩니다. 별도의 open()과 descriptor 복제는 같은 동작이 아닙니다.
이름을 찾는 dentry, 열린 상태를 나타내는 file, 파일 자체의 metadata를 담는 inode도 각각 다른 객체입니다. 이름을 제거하는 일과 열린 file을 닫는 일, cached folio를 버리는 일의 수명이 서로 달라질 수 있는 이유입니다.
descriptor 쪽 연결을 더 따라가면 task_struct.files의 files_struct, 그 안의 fdtable, fdtable.fd의 entry가 열린 file에 닿습니다. memory mapping 쪽에서는 VMA의 vm_file이 file을 참조합니다. 따라서 descriptor를 닫은 뒤에도 VMA를 통해 file이 살아 있을 수 있습니다. VMA를 찾는 자료구조까지 고정된 linked list로 외워서는 안 됩니다. v6.18의 mm_struct는 VMA 관리에 Maple Tree를 사용하며, 오래된 도식의 mmap field 이름을 현재 구조체에 그대로 대입할 수는 없습니다. VFS field, memory descriptor
cached data가 모이는 곳은 address_space입니다
file-backed folio의 mapping, inode의 i_mapping, file의 f_mapping이 만나는 객체가 struct address_space입니다. 이 address는 특정 process의 virtual address가 아닙니다. 파일의 논리 offset으로 cached data를 찾는 공간입니다. 하나의 folio가 파일 전체의 cache인 것도 아니며, mapping 하나가 여러 folio를 index로 관리합니다.
일반 inode에는 i_data라는 address_space가 내장되어 있고 i_mapping이 이를 가리킵니다. file은 이 mapping으로 들어가서 같은 file offset의 folio를 찾습니다. 별도로 열린 두 file의 position이 달라도 cached data를 공유할 수 있는 구조입니다.
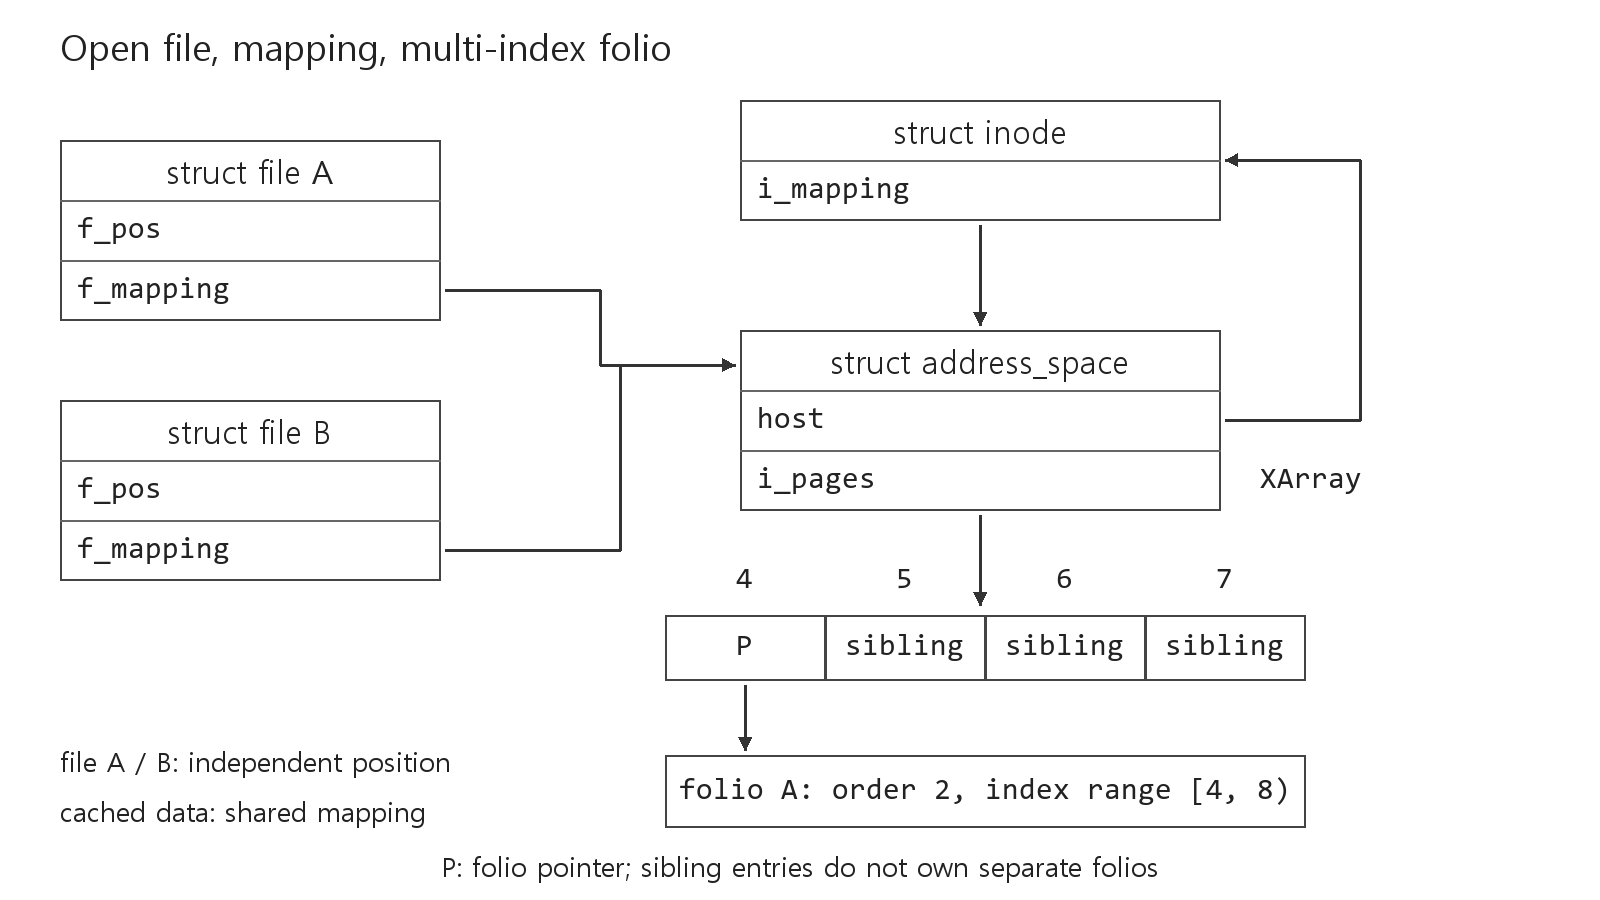
block device file처럼 다른 mapping을 사용하는 경우도 있습니다. /dev에 보이는 special-file inode와 장치 내용을 cache하는 inode를 같은 객체로 생각해서는 안 됩니다. inode에 내장 mapping이 있다는 사실이 모든 열린 file의 f_mapping이 언제나 그 객체를 사용한다는 규칙은 아닙니다.
초기화에도 객체 수명의 구분이 반영됩니다. inode_init_once()와 __address_space_init_once()는 XArray나 i_mmap tree 같은 일회성 준비를 담당하고, inode_init_always_gfp()는 inode를 사용할 때마다 host, callback, invalidate lock 등 필요한 상태를 준비합니다. filesystem이 더 큰 전용 inode 구조체 안에 VFS inode를 넣어 사용하더라도, 내장 mapping의 초기화 계약은 지켜야 합니다. inode와 address_space 초기화
callback은 객체마다 다른 책임을 맡습니다
VFS는 모든 filesystem의 on-disk 형식을 직접 알지 않습니다. 공통 객체와 callback 계약을 제공하고 filesystem이 그 계약을 구현합니다. 이름을 찾고 inode를 조작하는 작업은 inode_operations, 열린 파일의 read·write는 file_operations, cached folio의 read·dirty·writeback은 address_space_operations의 영역입니다.
mount된 filesystem instance의 중심에는 struct super_block이 있습니다. s_inodes는 그 instance의 inode들을 추적하고, super_operations는 inode allocation이나 filesystem 수준 동작에 관여합니다. memory mapping으로 만들어진 VMA에는 vm_operations_struct의 fault, map_pages, page_mkwrite 같은 callback이 참여합니다.
실제 callback table은 객체가 만들어지거나 inode가 준비되고 file이 열리는 경로에서 연결됩니다. 따라서 이름이 read_iter라는 사실만 확인하고 모든 filesystem이 동일한 generic helper를 사용한다고 가정해서는 안 됩니다. filesystem이 등록한 함수와 그 함수가 재사용하는 공통 구현을 함께 따라가야 합니다.
field를 함께 읽으면 이 연결이 더 분명합니다. inode의 i_op와 i_fop은 각각 inode와 file operation table을 가리킵니다. open 경로의 do_dentry_open()은 inode->i_fop에서 file의 f_op을 얻습니다. mapping에는 a_ops, superblock에는 s_op, VMA에는 vm_ops가 연결됩니다. filesystem의 mmap callback이 VMA operation을 정하므로 vm_ops가 file의 f_op과 같은 table인 것은 아닙니다. inode의 i_sb는 소속 superblock을, mapping의 host는 소유 inode를 가리키는 역방향 연결입니다. open 시 operation 연결
다음은 generic buffered read를 사용하는 경우의 구현코드가 아닌 호출관계입니다. VFS가 작업을 전달하는 층과 page cache를 찾는 층을 나누어 읽기 위한 그림입니다.
file_operations.read_iter
  filesystem read iterator
    generic_file_read_iter()
      filemap_read()
        address_space.i_pages
i_pages의 검색이 성공해도 실제 storage I/O나 filesystem private state의 처리는 a_ops로 내려갈 수 있습니다. 같은 page cache를 사용한다는 말은 모든 filesystem의 lock 순서, block mapping과 completion 구현까지 같다는 뜻이 아닙니다. VFS 객체와 operation table, generic read
close와 cache 제거는 다른 사건입니다
fd를 닫으면 그 descriptor의 연결을 놓습니다. 하지만 page cache가 보유한 folio 참조나 VMA가 유지하는 file 참조가 남아 있을 수 있으므로, 그 즉시 cached data가 allocator로 돌아가는 것은 아닙니다. 반대로 folio를 cache에서 제거하더라도 이미 lookup 참조를 얻은 reader 때문에 객체 자체는 더 살아 있을 수 있습니다.
munmap()도 mapping을 없애는 동작이지 성공한 fsync()의 대체물이 아닙니다. dirty tracking 덕분에 writeback 대상이 사라지지 않는 것과 application이 기다려야 할 durability 계약을 마친 것은 구별해야 합니다. mapping에서 변경한 범위를 명시적으로 동기화하려면 msync() 등 해당 API의 완료 조건을 사용해야 합니다. mmap과 munmap의 계약
결국 page cache는 process별 파일 buffer의 단순한 모음이 아닙니다. 열린 file이 가리키는 공유 mapping, 그 mapping 안의 folio, process별 page table을 나누어 보면 read와 fault, close와 eviction이 왜 서로 다른 검사를 수행하는지 자연스럽게 이어집니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access 2025, Chapter 9의 page cache 도입부와 §9.1.
- Linux v6.18: fs.h, inode.c, filemap.c.
- mmap(2), munmap(2).