put_page()가 호출되었다는 사실과 그 physical 범위가 큰 free block에 합쳐졌다는 사실은 다릅니다. 다른 참조가 남아 있을 수 있고, 마지막 참조가 사라져도 PCP가 잠시 보관할 수 있습니다. buddy에 도착하더라도 짝의 상태나 migrate type 때문에 합병이 멈출 수 있습니다.
Linux v6.1의 반환 경로를 수명 종료, PCP drain, buddy coalescing으로 나누어 보겠습니다. allocation의 반대 방향이지만 단순히 호출 순서만 뒤집은 구조는 아닙니다.
해제 API는 어떤 소유권을 내려놓는지부터 다릅니다
get_page()·folio_get() 등으로 보유한 참조는 대응하는 put 계열로 돌려줍니다. 마지막 참조가 아니면 page allocator로 반환하지 않습니다. user mapping이 없어졌다고, 또는 mapcount가 0이라고 이 reference protocol을 건너뛸 수는 없습니다.
order를 알고 반환하는 __free_pages(page, order)와 주소를 받는 free_pages() 계열도 있습니다. __free_page() 같은 order-0 wrapper와 higher-order API의 계약을 혼동하지 않아야 합니다. 잘못된 order를 넘겼을 때 allocator가 원래 allocation 크기를 항상 찾아 복구해 주는 것은 아닙니다.
__free_pages()는 먼저 head의 reference 감소 결과를 확인합니다. non-compound higher-order allocation에는 head에 speculative reference가 남아 있을 때 나머지 부분을 처리하는 별도 분기가 있습니다. compound allocation은 head 중심의 하나의 수명 단위이므로 같은 방식으로 tail을 임의 분리하지 않습니다. 이 차이가 higher-order와 compound를 구별해야 하는 또 하나의 이유입니다.
folio의 최종 put에서는 LRU, memcg, device 또는 compound destructor 등 역할별 정리가 연결됩니다. v6.1의 ordinary small-folio 경로인 __folio_put_small()은 cache/LRU 쪽 정리와 memcg uncharge 뒤 order-0 반환으로 내려갑니다. large 경로는 destroy_large_folio()로 연결되며 HugeTLB에는 일반 THP의 cache/LRU 정리를 무조건 적용하지 않습니다. HugeTLB의 cgroup 계약도 별도입니다.
release_pages()처럼 여러 참조를 모아 처리하는 경로도 있습니다. ordinary order-0 page를 모은 list는 free_unref_page_list()로 넘길 수 있고 large folio는 해당 수명 처리로 분리합니다. 일반 page, large folio, HugeTLB, device의 수명을 하나의 무조건적인 free-list 삽입으로 합치면 필요한 정리를 빠뜨립니다.
준비 검사를 통과한 page만 free 상태로 전환합니다
반환 경로는 free_pages_prepare() 계열에서 mapping, refcount, mapcount와 flag가 기대한 상태인지 확인하고 configuration에 맞는 sanitizer·initialization 작업을 수행합니다. 아직 owner가 사용하는 page를 free list에 넣으면 즉시 다른 allocation에 재사용될 수 있으므로 이 경계는 중요합니다.
PCP 지원 order라면 free_unref_page()를 통해 CPU cache에 보관할 수 있습니다. 일반 PCP list index는 주로 UNMOVABLE·RECLAIMABLE·MOVABLE을 다룹니다. CMA나 HIGHATOMIC 관련 page를 어떤 PCP list에 놓는지와 원래 pageblock의 type을 기록하는 cached 정보는 같은 값이 아닐 수 있습니다. ISOLATE는 일반 PCP 공급원에 숨겨 두지 않고 별도 buddy 반환 경로로 보냅니다.
PCP lock을 얻지 못했을 때도 zone 쪽 반환으로 우회할 수 있습니다. per-CPU 자료라고 동기화가 필요 없는 것이 아닙니다. 여러 order-0 page를 모아 반환하는 list 경로는 같은 zone의 PCP lock을 재사용하되 IRQ를 지나치게 오래 막지 않도록 중간에 lock을 놓는 처리도 갖습니다.
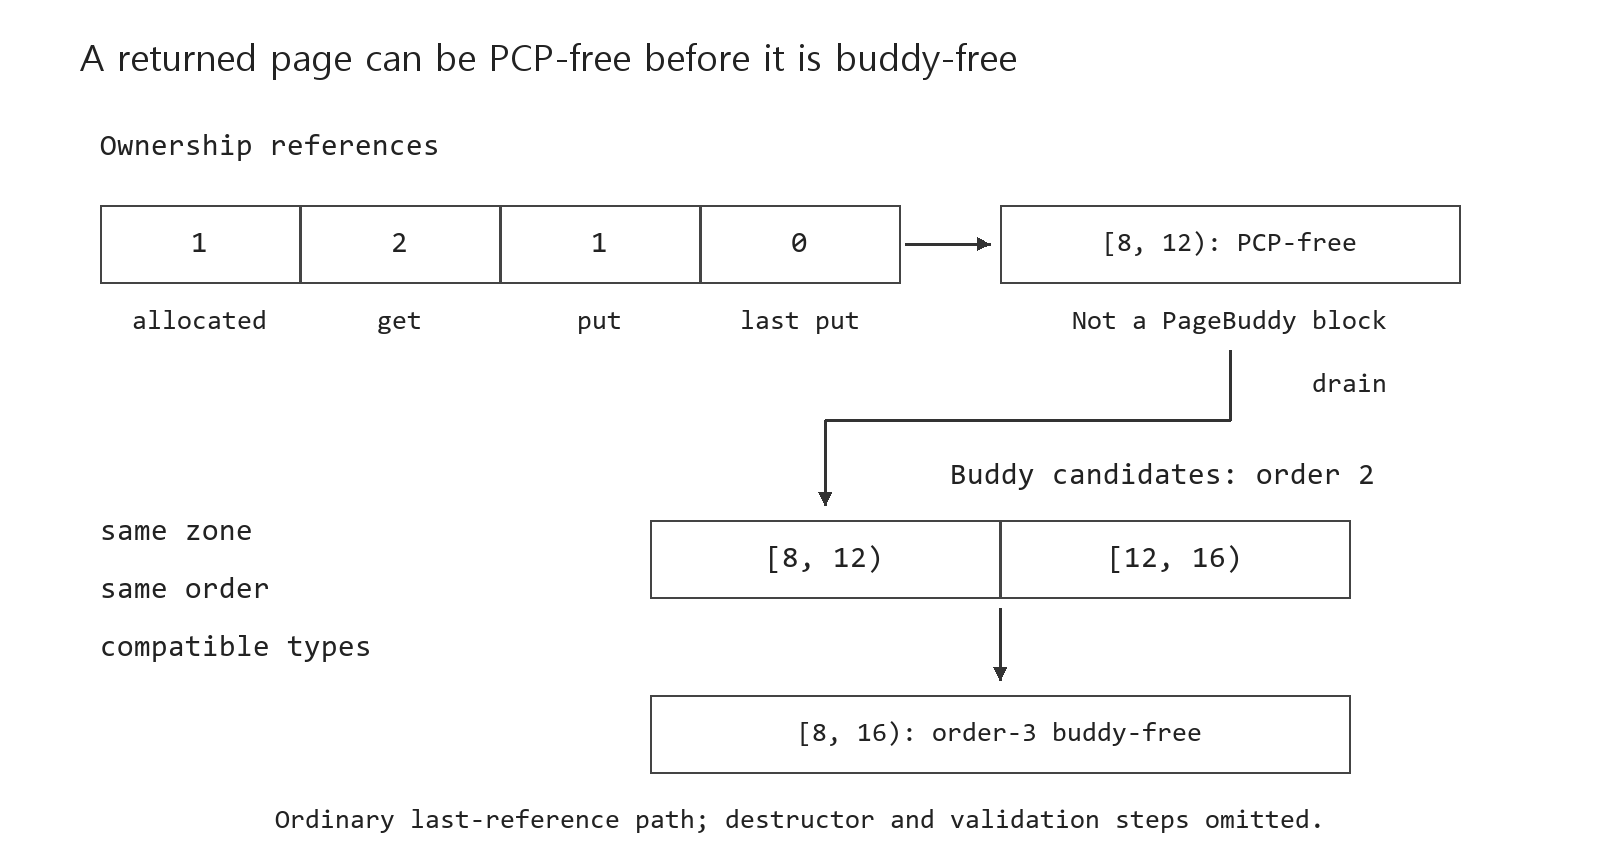
PCP high는 reclaim과 연속 free에 따라 달라집니다
free_unref_page_commit()은 해당 PCP list에 block을 추가하고 base-page 단위 count를 늘립니다. 그다음 유효 high와 비교해 drain할지 결정합니다. allocation 하나와 free 하나를 반드시 buddy까지 왕복시키지 않도록 하는 cache 정책입니다.
nr_pcp_high()는 PCP가 비활성인 high 0 상태이거나 적극적인 higher-order free 조건이면 유효 high를 0으로 취급합니다. zone에서 reclaim이 진행 중이면 min(high, 4 * batch)처럼 cache가 붙잡을 양을 줄입니다. reclaim이 memory를 필요로 하는 동안 CPU cache에 너무 많은 free를 남기지 않으려는 조치입니다.
v6.1의 free_high 조건에는 기존 free_factor가 양수이고, free order가 0보다 크며 PAGE_ALLOC_COSTLY_ORDER 이하라는 검사가 함께 있습니다. 모든 higher-order free나 모든 THP 반환을 항상 즉시 drain한다는 규칙이 아닙니다. 연속 free 양상과 지원 order의 성격을 함께 반영합니다.
nr_pcp_free()는 적극적인 free-high 상황에서는 PCP count 전체를 대상으로 합니다. high가 batch보다 작으면 최소 반환 분기로 가고, 일반적으로 batch를 free_factor만큼 shift한 뒤 허용 범위로 제한합니다. 연속 free가 이어지면 지수를 늘려 다음 drain을 더 크게 하고 allocation 경로는 그 경향을 낮춥니다. 실제 count가 적은데도 반드시 batch만큼 남기는 보편적 보장은 아닙니다.
Drain은 list를 돌며 현재 pageblock 정책을 재확인합니다
free_pcppages_bulk()는 요구 count와 실제 PCP count를 맞추고 zone lock 아래에서 page들을 buddy에 돌려줍니다. order·migrate type별 list를 round-robin으로 순회하고 비어 있는 index 범위를 줄여 불필요한 탐색을 피합니다. list의 뒤쪽에서 꺼내므로 최근 반환 page의 빠른 재사용을 남기는 방향과도 연결됩니다.
여기서 count는 base page 수이고 entry는 order별 block입니다. 필요한 양이 block 크기에 딱 맞지 않더라도 block을 임의로 부분 반환하지 않으므로 목표량을 넘어 drain할 수 있습니다. PCP count와 요청 count를 같은 단위로 줄이고 trace·검증을 함께 수행해야 합니다.
page가 PCP에 머무는 동안 pageblock이 isolation에 들어갈 수 있습니다. zone에 isolated pageblock이 있으면 cached migrate type만 믿지 않고 현재 분류를 다시 읽습니다. __free_one_page()에 잘못된 type을 넘겨 일반 list로 되돌리면 offlining 같은 작업의 경계를 깨뜨릴 수 있기 때문입니다.
Buddy 후보는 계산한 뒤 반드시 검사합니다
__free_one_page()는 zone lock을 보유한 상태에서 accounting과 합병을 진행합니다. 같은 order의 buddy PFN은 XOR로 구하지만 실제 후보가 free buddy인지 또는 허용된 debug guard인지, 같은 order와 zone인지 확인해야 합니다. PCP의 free page는 아직 이 buddy list의 block이 아니므로 즉시 합병되지 않습니다.
pageblock 경계를 넘어 큰 order를 만들 때는 migrate type도 중요합니다. 같은 type이면 같은 특수 type끼리 합칠 수 있습니다. type이 서로 다를 경우에는 양쪽이 일반 mergeable type인지 확인합니다. UNMOVABLE과 MOVABLE이 다르다는 이유만으로 모든 합병을 막는 것도, CMA·ISOLATE와 ordinary block을 무조건 섞는 것도 아닙니다.
ordinary buddy라면 list에서 제거하고, guard라면 해당 guard 상태와 accounting을 해제합니다. parent 시작 PFN은 두 시작값의 AND로 정하고 order를 올려 반복합니다. 최대 order나 중단 조건에 도달하면 멈춥니다. compaction capture가 해당 block을 직접 받아 가는 조건에서는 최종 free list 삽입 없이 끝날 수도 있습니다.
마지막 list 위치도 다음 합병의 가능성을 바꿉니다
합병 후에는 최종 order를 기록하고 list 앞이나 뒤에 넣습니다. FPI_TO_TAIL은 tail 삽입을 강제합니다. shuffle이 적용되는 order라면 무작위 선택을 사용할 수 있고, 그 외에는 buddy_merge_likely()로 더 높은 단계의 합병 가능성을 살펴 tail 배치를 선택할 수 있습니다. shuffle 대상 order를 모든 build의 고정 숫자로 외우면 안 됩니다.
buddy_merge_likely()는 지금 짝을 바로 합칠 수 없더라도 다음 order의 이웃이 free라면 가까운 미래에 더 큰 합병이 가능할지를 보는 heuristic입니다. 지금 반환한 block을 곧 재할당하지 않도록 늦추는 선택이지 다음 합병을 예약하는 것은 아닙니다.
FPI flag도 목적별로 구별합니다. FPI_NONE은 기본값이고 FPI_SKIP_REPORT_NOTIFY는 free-page reporting 알림을 생략합니다. v6.1의 FPI_SKIP_KASAN_POISON은 제한된 tag-based KASAN poisoning 동작을 제어하지 모든 free 검사를 끄지 않습니다. reporting, sanitizer, list 위치는 각각 다른 기능입니다.
진입점이 달라도 같은 cleanup을 복제하지는 않습니다
한 흐름으로 읽기 어려운 부분은 API 이름이 아니라 소유권의 출발점과 이미 끝낸 cleanup입니다. 다음 표는 v6.1에서 이 글에 전문을 제시한 경로를 역할별로 묶은 것이며, kernel을 그대로 구현한 pseudocode나 모든 subsystem의 호출 목록은 아닙니다.
| 출발점 | 먼저 확인하는 계약 | 이어지는 반환 경로 |
|---|---|---|
put_page()·folio_put() |
보유 reference를 내리며 devmap 예외와 마지막 참조를 구별합니다. | __folio_put()에서 small·large로 나눕니다. |
| ordinary small folio | cache/LRU release와 memcg uncharge를 수행합니다. | free_unref_page()로 갑니다. |
| ordinary large folio | 필요한 cache/LRU 정리 뒤 destructor ID를 사용합니다. | 일반 compound라면 free_compound_page()·free_the_page()로 이어집니다. |
__pagevec_release()·release_pages() |
여러 reference를 내리고 device·large·ordinary를 나누며 LRU 처리를 묶습니다. | ordinary batch를 free_unref_page_list()로 넘깁니다. |
put_pages_list() |
전달 list의 LRU 정리 전제와 마지막 참조를 따릅니다. | large는 별도 처리하고 남은 ordinary list를 반환합니다. |
free_page()·free_pages()·__free_page()·__free_pages() |
caller가 주소·order와 allocation의 해제 짝을 지킵니다. | free_the_page()에서 지원 PCP order인지 나눕니다. |
| PCP를 사용하는 반환 | prepare·type·PCP lock 조건을 확인합니다. | commit은 PCP에 넣고 high에 도달한 경우 drain을 요청합니다. |
| PCP를 거치지 않는 반환 | prepare 뒤 IRQ-safe zone lock을 잡습니다. | __free_one_page()에서 합병·accounting·list 삽입을 수행합니다. |
HugeTLB·device 등은 이 ordinary 경로의 예외를 갖습니다. release_pages()가 ordinary batch를 처리할 때 매번 __page_cache_release()를 그대로 호출하는 것도 아닙니다. 실제 코드는 LRU lock을 재사용하며 대응하는 정리를 수행합니다. 이 차이를 지워 버리면 동일 cleanup의 중복 수행이나 누락을 알아보기 어렵습니다.
또한 header macro·inline API라는 사실과 EXPORT_SYMBOL 또는 EXPORT_SYMBOL_GPL로 별도 symbol을 export했다는 사실을 구별해야 합니다. 예를 들어 free_page()·__free_page()는 이 tag의 header macro입니다. 도식의 진입점 표시만 보고 실제 linker export 종류를 판단하지 않습니다.
마지막 참조와 API별 반환 계약의 실제 코드입니다
다음 네 함수는 Linux v6.1의 include/linux/mm.h에 있는 전문입니다. SPDX는 GPL-2.0이며 들여쓰기만 정리했습니다. reference를 내린 뒤 마지막 참조였을 수 있다면 memory뿐 아니라 그 descriptor도 임의로 계속 접근해서는 안 됩니다.
static inline int put_page_testzero(struct page *page)
{
    VM_BUG_ON_PAGE(page_ref_count(page) == 0, page);
    return page_ref_dec_and_test(page);
}
static inline int folio_put_testzero(struct folio *folio)
{
    return put_page_testzero(&folio->page);
}
static inline void put_page(struct page *page)
{
    struct folio *folio = page_folio(page);

    /*
     * For some devmap managed pages we need to catch refcount transition
     * from 2 to 1:
     */
    if (put_devmap_managed_page(&folio->page))
        return;
    folio_put(folio);
}
static inline void folio_put(struct folio *folio)
{
    if (folio_put_testzero(folio))
        __folio_put(folio);
}
put_page()는 tail을 folio로 정규화하고 일부 managed device page의 2→1 reference 전환을 먼저 처리합니다. 따라서 모든 public free가 똑같은 literal helper를 호출해 0에 도달한다는 단일 규칙은 아닙니다. folio_put()의 문서상 문맥은 process·interrupt와 spinlock 보유 상태를 허용하지만 NMI는 허용하지 않습니다. reference를 이미 보유한다는 전제도 별도입니다.
다음은 mm/page_alloc.c의 주소·order 기반 반환 함수 전문입니다. SPDX는 GPL-2.0-only입니다.
void __free_pages(struct page *page, unsigned int order)
{
    if (put_page_testzero(page))
        free_the_page(page, order);
    else if (!PageHead(page))
        while (order-- > 0)
            free_the_page(page + (1 << order), order);
}
void free_pages(unsigned long addr, unsigned int order)
{
    if (addr != 0) {
        VM_BUG_ON(!virt_addr_valid((void *)addr));
        __free_pages(virt_to_page((void *)addr), order);
    }
}
마지막 head reference라면 전달한 order로 반환하지만, 그렇지 않은 non-compound higher-order allocation에서는 남은 절반들을 따로 돌려줍니다. 참조가 남았다는 이유로 물리 범위 전체가 계속 같은 owner에게 보호된다고 해석할 수는 없습니다. compound head에는 이 분리를 그대로 적용하지 않습니다. free_pages()의 주소 0 처리는 이 함수의 계약이며 모든 put 함수가 NULL을 받아 준다는 뜻은 아닙니다.
order-0 macro는 gfp.h에 다음처럼 정의됩니다. 이 header의 SPDX는 GPL-2.0입니다.
#define __free_page(page) __free_pages((page), 0)
#define free_page(addr) free_pages((addr), 0)
exact allocation은 다음 free_pages_exact() 전문처럼 원래 size를 page 단위로 올림해 반환합니다. 이 함수의 SPDX는 GPL-2.0-only입니다.
void free_pages_exact(void *virt, size_t size)
{
    unsigned long addr = (unsigned long)virt;
    unsigned long end = addr + PAGE_ALIGN(size);

    while (addr < end) {
        free_page(addr);
        addr += PAGE_SIZE;
    }
}
Small, large, device의 최종 정리를 나눕니다
다음 네 함수는 mm/swap.c의 전문입니다. SPDX는 GPL-2.0-only입니다. LRU 정리, mlock 장부, memcg 해제와 destructor 선택이 free-list 삽입보다 먼저 있습니다.
void __folio_put(struct folio *folio)
{
    if (unlikely(folio_is_zone_device(folio)))
        free_zone_device_page(&folio->page);
    else if (unlikely(folio_test_large(folio)))
        __folio_put_large(folio);
    else
        __folio_put_small(folio);
}
static void __folio_put_small(struct folio *folio)
{
    __page_cache_release(folio);
    mem_cgroup_uncharge(folio);
    free_unref_page(&folio->page, 0);
}
static void __folio_put_large(struct folio *folio)
{
    /*
     * __page_cache_release() is supposed to be called for thp, not for
     * hugetlb. This is because hugetlb page does never have PageLRU set
     * (it's never listed to any LRU lists) and no memcg routines should
     * be called for hugetlb (it has a separate hugetlb_cgroup.)
     */
    if (!folio_test_hugetlb(folio))
        __page_cache_release(folio);
    destroy_large_folio(folio);
}
static void __page_cache_release(struct folio *folio)
{
    if (folio_test_lru(folio)) {
        struct lruvec *lruvec;
        unsigned long flags;

        lruvec = folio_lruvec_lock_irqsave(folio, &flags);
        lruvec_del_folio(lruvec, folio);
        __folio_clear_lru_flags(folio);
        unlock_page_lruvec_irqrestore(lruvec, flags);
    }
    /* See comment on folio_test_mlocked in release_pages() */
    if (unlikely(folio_test_mlocked(folio))) {
        long nr_pages = folio_nr_pages(folio);

        __folio_clear_mlocked(folio);
        zone_stat_mod_folio(folio, NR_MLOCK, -nr_pages);
        count_vm_events(UNEVICTABLE_PGCLEARED, nr_pages);
    }
}
ordinary small folio는 cache/LRU 정리 뒤 memcg를 uncharge하고 order-0으로 반환합니다. large folio는 HugeTLB인지 확인하여 cache 정리 적용 여부를 나누고 destructor로 갑니다. device는 이 ordinary RAM 경로와 다른 반환 함수를 사용합니다. 이런 예외까지 모든 physical free가 같은 buddy endpoint로 간다고 일반화하지 않습니다.
large destructor 선택과 일반 compound 반환의 실제 정의는 mm/page_alloc.c에 있습니다. SPDX는 GPL-2.0-only입니다.
void destroy_large_folio(struct folio *folio)
{
    enum compound_dtor_id dtor = folio_page(folio, 1)->compound_dtor;

    VM_BUG_ON_FOLIO(dtor >= NR_COMPOUND_DTORS, folio);
    compound_page_dtors[dtor](&folio->page);
}
void free_compound_page(struct page *page)
{
    mem_cgroup_uncharge(page_folio(page));
    free_the_page(page, compound_order(page));
}
destroy_large_folio()는 destructor index로 dispatch합니다. 이름만 보고 무조건 free_compound_page()를 직접 호출한다고 가정하면 HugeTLB 같은 별도 계약을 잃습니다. 일반 compound destructor는 memcg를 정리하고 실제 compound order로 공통 반환을 부릅니다.
Array와 list의 batch 반환은 같은 계약이 아닙니다
다음은 release_pages()·__pagevec_release()·put_pages_list()의 전문입니다. SPDX는 GPL-2.0-only입니다.
void release_pages(struct page **pages, int nr)
{
    int i;
    LIST_HEAD(pages_to_free);
    struct lruvec *lruvec = NULL;
    unsigned long flags = 0;
    unsigned int lock_batch;

    for (i = 0; i < nr; i++) {
        struct folio *folio = page_folio(pages[i]);

        /*
         * Make sure the IRQ-safe lock-holding time does not get
         * excessive with a continuous string of pages from the
         * same lruvec. The lock is held only if lruvec != NULL.
         */
        if (lruvec && ++lock_batch == SWAP_CLUSTER_MAX) {
            unlock_page_lruvec_irqrestore(lruvec, flags);
            lruvec = NULL;
        }

        if (is_huge_zero_page(&folio->page))
            continue;

        if (folio_is_zone_device(folio)) {
            if (lruvec) {
                unlock_page_lruvec_irqrestore(lruvec, flags);
                lruvec = NULL;
            }
            if (put_devmap_managed_page(&folio->page))
                continue;
            if (folio_put_testzero(folio))
                free_zone_device_page(&folio->page);
            continue;
        }

        if (!folio_put_testzero(folio))
            continue;

        if (folio_test_large(folio)) {
            if (lruvec) {
                unlock_page_lruvec_irqrestore(lruvec, flags);
                lruvec = NULL;
            }
            __folio_put_large(folio);
            continue;
        }

        if (folio_test_lru(folio)) {
            struct lruvec *prev_lruvec = lruvec;

            lruvec = folio_lruvec_relock_irqsave(folio, lruvec,
                                    &flags);
            if (prev_lruvec != lruvec)
                lock_batch = 0;

            lruvec_del_folio(lruvec, folio);
            __folio_clear_lru_flags(folio);
        }

        /*
         * In rare cases, when truncation or holepunching raced with
         * munlock after VM_LOCKED was cleared, Mlocked may still be
         * found set here.  This does not indicate a problem, unless
         * "unevictable_pgs_cleared" appears worryingly large.
         */
        if (unlikely(folio_test_mlocked(folio))) {
            __folio_clear_mlocked(folio);
            zone_stat_sub_folio(folio, NR_MLOCK);
            count_vm_event(UNEVICTABLE_PGCLEARED);
        }

        list_add(&folio->lru, &pages_to_free);
    }
    if (lruvec)
        unlock_page_lruvec_irqrestore(lruvec, flags);

    mem_cgroup_uncharge_list(&pages_to_free);
    free_unref_page_list(&pages_to_free);
}
void __pagevec_release(struct pagevec *pvec)
{
    if (!pvec->percpu_pvec_drained) {
        lru_add_drain();
        pvec->percpu_pvec_drained = true;
    }
    release_pages(pvec->pages, pagevec_count(pvec));
    pagevec_reinit(pvec);
}
void put_pages_list(struct list_head *pages)
{
    struct folio *folio, *next;

    list_for_each_entry_safe(folio, next, pages, lru) {
        if (!folio_put_testzero(folio)) {
            list_del(&folio->lru);
            continue;
        }
        if (folio_test_large(folio)) {
            list_del(&folio->lru);
            __folio_put_large(folio);
            continue;
        }
        /* LRU flag must be clear because it's passed using the lru */
    }

    free_unref_page_list(pages);
    INIT_LIST_HEAD(pages);
}
array 경로는 large·device를 분리하고 ordinary small folio들을 모읍니다. 같은 lruvec의 lock을 재사용하되 batch가 길어지면 IRQ-safe lock을 놓아 긴 보유를 제한합니다. 이 구현의 LRU 정리는 loop 안에서 직접 수행하며, 모든 항목에 __page_cache_release()를 literal 호출하는 것은 아닙니다. 끝에서는 memcg list uncharge와 allocator 반환을 나눕니다. pagevec wrapper가 먼저 LRU-add queue를 drain하는 이유도 그 queue가 보유한 참조 때문에 반환이 늦어질 수 있기 때문입니다.
반면 put_pages_list()의 list는 lru member로 연결되어 있어 LRU flag가 이미 clear인 전제가 있습니다. reference가 남은 항목과 large folio를 list에서 빼고 남은 ordinary 항목을 넘깁니다. array 경로의 LRU·memcg 정리와 같은 계약이라고 전제해 임의 subsystem list를 전달해서는 안 됩니다. static inline API, global 정의, module export도 서로 다른 정보입니다.
반환 준비는 정상 공급원에 다시 넣어도 되는지 검사합니다
다음은 free_pages_prepare() 전문입니다. SPDX는 GPL-2.0-only입니다. false는 이 block을 정상 PCP·buddy 공급원에 넣어서는 안 된다는 결과입니다.
static __always_inline bool free_pages_prepare(struct page *page,
            unsigned int order, bool check_free, fpi_t fpi_flags)
{
    int bad = 0;
    bool init = want_init_on_free();

    VM_BUG_ON_PAGE(PageTail(page), page);

    trace_mm_page_free(page, order);
    kmsan_free_page(page, order);

    if (unlikely(PageHWPoison(page)) && !order) {
        /*
         * Do not let hwpoison pages hit pcplists/buddy
         * Untie memcg state and reset page's owner
         */
        if (memcg_kmem_enabled() && PageMemcgKmem(page))
            __memcg_kmem_uncharge_page(page, order);
        reset_page_owner(page, order);
        page_table_check_free(page, order);
        return false;
    }

    /*
     * Check tail pages before head page information is cleared to
     * avoid checking PageCompound for order-0 pages.
     */
    if (unlikely(order)) {
        bool compound = PageCompound(page);
        int i;

        VM_BUG_ON_PAGE(compound && compound_order(page) != order, page);

        if (compound) {
            ClearPageDoubleMap(page);
            ClearPageHasHWPoisoned(page);
        }
        for (i = 1; i < (1 << order); i++) {
            if (compound)
                bad += free_tail_pages_check(page, page + i);
            if (unlikely(free_page_is_bad(page + i))) {
                bad++;
                continue;
            }
            (page + i)->flags &= ~PAGE_FLAGS_CHECK_AT_PREP;
        }
    }
    if (PageMappingFlags(page))
        page->mapping = NULL;
    if (memcg_kmem_enabled() && PageMemcgKmem(page))
        __memcg_kmem_uncharge_page(page, order);
    if (check_free && free_page_is_bad(page))
        bad++;
    if (bad)
        return false;

    page_cpupid_reset_last(page);
    page->flags &= ~PAGE_FLAGS_CHECK_AT_PREP;
    reset_page_owner(page, order);
    page_table_check_free(page, order);

    if (!PageHighMem(page)) {
        debug_check_no_locks_freed(page_address(page),
                       PAGE_SIZE << order);
        debug_check_no_obj_freed(page_address(page),
                       PAGE_SIZE << order);
    }

    kernel_poison_pages(page, 1 << order);

    /*
     * As memory initialization might be integrated into KASAN,
     * KASAN poisoning and memory initialization code must be
     * kept together to avoid discrepancies in behavior.
     *
     * With hardware tag-based KASAN, memory tags must be set before the
     * page becomes unavailable via debug_pagealloc or arch_free_page.
     */
    if (!should_skip_kasan_poison(page, fpi_flags)) {
        kasan_poison_pages(page, order, init);

        /* Memory is already initialized if KASAN did it internally. */
        if (kasan_has_integrated_init())
            init = false;
    }
    if (init)
        kernel_init_pages(page, 1 << order);

    /*
     * arch_free_page() can make the page's contents inaccessible.  s390
     * does this.  So nothing which can access the page's contents should
     * happen after this.
     */
    arch_free_page(page, order);

    debug_pagealloc_unmap_pages(page, 1 << order);

    return true;
}
order-0 hardware-poison의 early return은 memcg·owner·page-table 장부를 정리하되 일반 공급원에는 넣지 않습니다. higher-order에서는 head 정보를 지우기 전에 tail을 검사하고 compound order도 확인합니다. bad 상태가 있으면 성공 반환으로 계속 가지 않습니다. 이는 warning을 남기고 같은 page를 정상 결과로 되돌리는 경로가 아닙니다.
정상 경로에서도 mapping tag·memcg·cpupid·owner·검사 flag를 정리한 뒤 poison과 초기화를 수행합니다. architecture hook이 contents 접근을 불가능하게 만들 수 있어 contents를 만지는 작업들이 그보다 앞에 있습니다. tail 검사, head 검사 선택, sanitizer 동작과 실제 free-list 삽입은 서로 다른 단계입니다.
PCP의 검사 시점은 같은 파일의 다음 전체 조건부 영역처럼 구성에 따라 달라집니다. SPDX는 GPL-2.0-only입니다.
#ifdef CONFIG_DEBUG_VM
/*
 * With DEBUG_VM enabled, order-0 pages are checked immediately when being freed
 * to pcp lists. With debug_pagealloc also enabled, they are also rechecked when
 * moved from pcp lists to free lists.
 */
static bool free_pcp_prepare(struct page *page, unsigned int order)
{
    return free_pages_prepare(page, order, true, FPI_NONE);
}

/* return true if this page has an inappropriate state */
static bool bulkfree_pcp_prepare(struct page *page)
{
    if (debug_pagealloc_enabled_static())
        return free_page_is_bad(page);
    else
        return false;
}
#else
/*
 * With DEBUG_VM disabled, order-0 pages being freed are checked only when
 * moving from pcp lists to free list in order to reduce overhead. With
 * debug_pagealloc enabled, they are checked also immediately when being freed
 * to the pcp lists.
 */
static bool free_pcp_prepare(struct page *page, unsigned int order)
{
    if (debug_pagealloc_enabled_static())
        return free_pages_prepare(page, order, true, FPI_NONE);
    else
        return free_pages_prepare(page, order, false, FPI_NONE);
}

static bool bulkfree_pcp_prepare(struct page *page)
{
    return free_page_is_bad(page);
}
#endif /* CONFIG_DEBUG_VM */
DEBUG_VM이면 PCP에 넣기 전에 head 상태를 검사하고 debug-pagealloc이 켜지면 drain에서도 다시 검사합니다. DEBUG_VM이 없으면 기본 head 검사를 drain 쪽에 미루며, debug-pagealloc이 켜졌을 때 즉시 검사도 수행합니다. check_free가 false라고 모든 준비 작업과 tail 검사가 사라지는 것은 아닙니다.
Order와 isolation이 PCP 우회를 결정합니다
다음은 같은 tag의 pcp_allowed_order()·free_the_page()·__free_pages_ok()·free_one_page() 전문입니다. SPDX는 GPL-2.0-only입니다.
static inline bool pcp_allowed_order(unsigned int order)
{
    if (order <= PAGE_ALLOC_COSTLY_ORDER)
        return true;
#ifdef CONFIG_TRANSPARENT_HUGEPAGE
    if (order == pageblock_order)
        return true;
#endif
    return false;
}
static inline void free_the_page(struct page *page, unsigned int order)
{
    if (pcp_allowed_order(order))        /* Via pcp? */
        free_unref_page(page, order);
    else
        __free_pages_ok(page, order, FPI_NONE);
}
static void __free_pages_ok(struct page *page, unsigned int order,
                fpi_t fpi_flags)
{
    unsigned long flags;
    int migratetype;
    unsigned long pfn = page_to_pfn(page);
    struct zone *zone = page_zone(page);

    if (!free_pages_prepare(page, order, true, fpi_flags))
        return;

    migratetype = get_pfnblock_migratetype(page, pfn);

    spin_lock_irqsave(&zone->lock, flags);
    if (unlikely(has_isolate_pageblock(zone) ||
        is_migrate_isolate(migratetype))) {
        migratetype = get_pfnblock_migratetype(page, pfn);
    }
    __free_one_page(page, pfn, zone, order, migratetype, fpi_flags);
    spin_unlock_irqrestore(&zone->lock, flags);

    __count_vm_events(PGFREE, 1 << order);
}
static void free_one_page(struct zone *zone,
                struct page *page, unsigned long pfn,
                unsigned int order,
                int migratetype, fpi_t fpi_flags)
{
    unsigned long flags;

    spin_lock_irqsave(&zone->lock, flags);
    if (unlikely(has_isolate_pageblock(zone) ||
        is_migrate_isolate(migratetype))) {
        migratetype = get_pfnblock_migratetype(page, pfn);
    }
    __free_one_page(page, pfn, zone, order, migratetype, fpi_flags);
    spin_unlock_irqrestore(&zone->lock, flags);
}
일반 낮은 order와 구성에 따른 THP용 order가 PCP 후보가 됩니다. 그렇지 않은 block은 직접 준비 검사와 zone lock을 거칩니다. isolation이 있을 수 있으면 lock 안에서 pageblock type을 다시 읽습니다. 예전에 저장한 type을 끝까지 확정된 소유권처럼 쓰지 않습니다.
PCP 후보의 준비와 실제 commit은 다음 free_unref_page_prepare()·free_unref_page()·free_unref_page_commit() 전문으로 연결됩니다. SPDX는 GPL-2.0-only입니다.
static bool free_unref_page_prepare(struct page *page, unsigned long pfn,
                            unsigned int order)
{
    int migratetype;

    if (!free_pcp_prepare(page, order))
        return false;

    migratetype = get_pfnblock_migratetype(page, pfn);
    set_pcppage_migratetype(page, migratetype);
    return true;
}
void free_unref_page(struct page *page, unsigned int order)
{
    unsigned long flags;
    unsigned long __maybe_unused UP_flags;
    struct per_cpu_pages *pcp;
    struct zone *zone;
    unsigned long pfn = page_to_pfn(page);
    int migratetype;

    if (!free_unref_page_prepare(page, pfn, order))
        return;

    /*
     * We only track unmovable, reclaimable and movable on pcp lists.
     * Place ISOLATE pages on the isolated list because they are being
     * offlined but treat HIGHATOMIC as movable pages so we can get those
     * areas back if necessary. Otherwise, we may have to free
     * excessively into the page allocator
     */
    migratetype = get_pcppage_migratetype(page);
    if (unlikely(migratetype >= MIGRATE_PCPTYPES)) {
        if (unlikely(is_migrate_isolate(migratetype))) {
            free_one_page(page_zone(page), page, pfn, order, migratetype, FPI_NONE);
            return;
        }
        migratetype = MIGRATE_MOVABLE;
    }

    zone = page_zone(page);
    pcp_trylock_prepare(UP_flags);
    pcp = pcp_spin_trylock_irqsave(zone->per_cpu_pageset, flags);
    if (pcp) {
        free_unref_page_commit(zone, pcp, page, migratetype, order);
        pcp_spin_unlock_irqrestore(pcp, flags);
    } else {
        free_one_page(zone, page, pfn, order, migratetype, FPI_NONE);
    }
    pcp_trylock_finish(UP_flags);
}
static void free_unref_page_commit(struct zone *zone, struct per_cpu_pages *pcp,
                   struct page *page, int migratetype,
                   unsigned int order)
{
    int high;
    int pindex;
    bool free_high;

    __count_vm_events(PGFREE, 1 << order);
    pindex = order_to_pindex(migratetype, order);
    list_add(&page->pcp_list, &pcp->lists[pindex]);
    pcp->count += 1 << order;

    /*
     * As high-order pages other than THP's stored on PCP can contribute
     * to fragmentation, limit the number stored when PCP is heavily
     * freeing without allocation. The remainder after bulk freeing
     * stops will be drained from vmstat refresh context.
     */
    free_high = (pcp->free_factor && order && order <= PAGE_ALLOC_COSTLY_ORDER);

    high = nr_pcp_high(pcp, zone, free_high);
    if (pcp->count >= high) {
        int batch = READ_ONCE(pcp->batch);

        free_pcppages_bulk(zone, nr_pcp_free(pcp, high, batch, free_high), pcp, pindex);
    }
}
ISOLATE는 직접 buddy 반환 쪽으로 보냅니다. 일반 PCP type 범위를 넘는 다른 type은 MOVABLE PCP list를 사용하되 descriptor에 저장한 원래 분류와 나중의 pageblock 재조회도 구별합니다. trylock을 얻지 못하면 정상적으로 zone 쪽으로 우회합니다. commit은 PCP list에 넣는 동작이며 PCP에서 buddy로 drain하는 동작과 반대 방향입니다. 이 tag의 PGFREE event도 1 << order인 base-page 수를 반영합니다.
free_factor는 모든 free 호출마다 무조건 증가하는 counter가 아닙니다. drain 양을 계산하는 nr_pcp_free()의 조건에서 증가하며 allocation은 지수를 낮춥니다. free_high는 그러한 연속 free 경향과 작은 higher-order 조건을 함께 봅니다. nr_pcp_high()와 nr_pcp_free()의 전체 정의는 PCP 정책 글에 있으며, 계산값·실제 count cap·block granularity를 함께 적용해야 합니다.
여러 order-0 page를 모은 경로의 실제 정의는 다음과 같습니다. free_unref_page_list() 전문이며 SPDX는 GPL-2.0-only입니다.
void free_unref_page_list(struct list_head *list)
{
    struct page *page, *next;
    struct per_cpu_pages *pcp = NULL;
    struct zone *locked_zone = NULL;
    unsigned long flags;
    int batch_count = 0;
    int migratetype;

    /* Prepare pages for freeing */
    list_for_each_entry_safe(page, next, list, lru) {
        unsigned long pfn = page_to_pfn(page);
        if (!free_unref_page_prepare(page, pfn, 0)) {
            list_del(&page->lru);
            continue;
        }

        /*
         * Free isolated pages directly to the allocator, see
         * comment in free_unref_page.
         */
        migratetype = get_pcppage_migratetype(page);
        if (unlikely(is_migrate_isolate(migratetype))) {
            list_del(&page->lru);
            free_one_page(page_zone(page), page, pfn, 0, migratetype, FPI_NONE);
            continue;
        }
    }

    list_for_each_entry_safe(page, next, list, lru) {
        struct zone *zone = page_zone(page);

        /* Different zone, different pcp lock. */
        if (zone != locked_zone) {
            if (pcp)
                pcp_spin_unlock_irqrestore(pcp, flags);

            locked_zone = zone;
            pcp = pcp_spin_lock_irqsave(locked_zone->per_cpu_pageset, flags);
        }

        /*
         * Non-isolated types over MIGRATE_PCPTYPES get added
         * to the MIGRATE_MOVABLE pcp list.
         */
        migratetype = get_pcppage_migratetype(page);
        if (unlikely(migratetype >= MIGRATE_PCPTYPES))
            migratetype = MIGRATE_MOVABLE;

        trace_mm_page_free_batched(page);
        free_unref_page_commit(zone, pcp, page, migratetype, 0);

        /*
         * Guard against excessive IRQ disabled times when we get
         * a large list of pages to free.
         */
        if (++batch_count == SWAP_CLUSTER_MAX) {
            pcp_spin_unlock_irqrestore(pcp, flags);
            batch_count = 0;
            pcp = pcp_spin_lock_irqsave(locked_zone->per_cpu_pageset, flags);
        }
    }

    if (pcp)
        pcp_spin_unlock_irqrestore(pcp, flags);
}
첫 순회에서 준비에 실패한 page와 isolated page를 분리하고, 두 번째 순회에서 zone별 PCP lock을 재사용합니다. safe iterator는 다음 항목을 먼저 확보하므로 commit이 descriptor의 list 저장 공간을 재사용한 뒤 이전 list 연결을 계속 따라가지 않습니다. 마지막 lock 해제와 batch 중간의 IRQ-disabled 구간 제한도 함께 있어야 합니다.
Drain과 합병을 끝까지 잇는 실제 구현입니다
다음 세 함수는 Linux v6.1의 mm/page_alloc.c에 있는 전문이며 SPDX는 GPL-2.0-only입니다. 이 글의 코드들은 kernel 내부 type과 helper를 사용하는 함수 단위의 source이며 standalone 실습 프로그램은 아닙니다. 들여쓰기를 정리했으며 다른 kernel tag나 책의 생략 부분을 복원한 코드로 제시하지 않습니다.
static void free_pcppages_bulk(struct zone *zone, int count,
                    struct per_cpu_pages *pcp,
                    int pindex)
{
    int min_pindex = 0;
    int max_pindex = NR_PCP_LISTS - 1;
    unsigned int order;
    bool isolated_pageblocks;
    struct page *page;

    /*
     * Ensure proper count is passed which otherwise would stuck in the
     * below while (list_empty(list)) loop.
     */
    count = min(pcp->count, count);

    /* Ensure requested pindex is drained first. */
    pindex = pindex - 1;

    /* Caller must hold IRQ-safe pcp->lock so IRQs are disabled. */
    spin_lock(&zone->lock);
    isolated_pageblocks = has_isolate_pageblock(zone);

    while (count > 0) {
        struct list_head *list;
        int nr_pages;

        /* Remove pages from lists in a round-robin fashion. */
        do {
            if (++pindex > max_pindex)
                pindex = min_pindex;
            list = &pcp->lists[pindex];
            if (!list_empty(list))
                break;

            if (pindex == max_pindex)
                max_pindex--;
            if (pindex == min_pindex)
                min_pindex++;
        } while (1);

        order = pindex_to_order(pindex);
        nr_pages = 1 << order;
        do {
            int mt;

            page = list_last_entry(list, struct page, pcp_list);
            mt = get_pcppage_migratetype(page);

            /* must delete to avoid corrupting pcp list */
            list_del(&page->pcp_list);
            count -= nr_pages;
            pcp->count -= nr_pages;

            if (bulkfree_pcp_prepare(page))
                continue;

            /* MIGRATE_ISOLATE page should not go to pcplists */
            VM_BUG_ON_PAGE(is_migrate_isolate(mt), page);
            /* Pageblock could have been isolated meanwhile */
            if (unlikely(isolated_pageblocks))
                mt = get_pageblock_migratetype(page);

            __free_one_page(page, page_to_pfn(page), zone, order, mt, FPI_NONE);
            trace_mm_page_pcpu_drain(page, order, mt);
        } while (count > 0 && !list_empty(list));
    }

    spin_unlock(&zone->lock);
}
호출자는 IRQ-safe PCP lock을 이미 보유하고, 이 함수가 그 안에서 zone lock을 얻습니다. count = min(pcp->count, count)는 존재하지 않는 entry를 끝없이 찾지 않게 하는 전제입니다. 요청받은 index를 먼저 검사한 뒤 비어 있는 양끝 index를 줄이며 순환합니다. PCP에서 빠지는 양은 entry 수가 아니라 1 << order입니다. 따라서 마지막 block 때문에 요청량을 넘길 수 있습니다.
list에서 꺼내고 count를 줄인 뒤 검증이 실패한 page는 정상 buddy 삽입으로 보내지 않습니다. 원래 cached migrate type은 PCP에 넣을 때의 정보입니다. pageblock isolation 가능성이 있는 zone에서는 현재 pageblock type을 다시 읽어 넘깁니다. 이 과정과 합병이 끝나야 buddy free counter의 accounting으로 넘어갑니다. PCP count와 buddy free counter를 같은 순간의 동일한 집합으로 더하면 안 됩니다.
static inline void __free_one_page(struct page *page,
        unsigned long pfn,
        struct zone *zone, unsigned int order,
        int migratetype, fpi_t fpi_flags)
{
    struct capture_control *capc = task_capc(zone);
    unsigned long buddy_pfn = 0;
    unsigned long combined_pfn;
    struct page *buddy;
    bool to_tail;

    VM_BUG_ON(!zone_is_initialized(zone));
    VM_BUG_ON_PAGE(page->flags & PAGE_FLAGS_CHECK_AT_PREP, page);

    VM_BUG_ON(migratetype == -1);
    if (likely(!is_migrate_isolate(migratetype)))
        __mod_zone_freepage_state(zone, 1 << order, migratetype);

    VM_BUG_ON_PAGE(pfn & ((1 << order) - 1), page);
    VM_BUG_ON_PAGE(bad_range(zone, page), page);

    while (order < MAX_ORDER - 1) {
        if (compaction_capture(capc, page, order, migratetype)) {
            __mod_zone_freepage_state(zone, -(1 << order),
                                migratetype);
            return;
        }

        buddy = find_buddy_page_pfn(page, pfn, order, &buddy_pfn);
        if (!buddy)
            goto done_merging;

        if (unlikely(order >= pageblock_order)) {
            /*
             * We want to prevent merge between freepages on pageblock
             * without fallbacks and normal pageblock. Without this,
             * pageblock isolation could cause incorrect freepage or CMA
             * accounting or HIGHATOMIC accounting.
             */
            int buddy_mt = get_pageblock_migratetype(buddy);

            if (migratetype != buddy_mt
                    && (!migratetype_is_mergeable(migratetype) ||
                        !migratetype_is_mergeable(buddy_mt)))
                goto done_merging;
        }

        /*
         * Our buddy is free or it is CONFIG_DEBUG_PAGEALLOC guard page,
         * merge with it and move up one order.
         */
        if (page_is_guard(buddy))
            clear_page_guard(zone, buddy, order, migratetype);
        else
            del_page_from_free_list(buddy, zone, order);
        combined_pfn = buddy_pfn & pfn;
        page = page + (combined_pfn - pfn);
        pfn = combined_pfn;
        order++;
    }

done_merging:
    set_buddy_order(page, order);

    if (fpi_flags & FPI_TO_TAIL)
        to_tail = true;
    else if (is_shuffle_order(order))
        to_tail = shuffle_pick_tail();
    else
        to_tail = buddy_merge_likely(pfn, buddy_pfn, page, order);

    if (to_tail)
        add_to_free_list_tail(page, zone, order, migratetype);
    else
        add_to_free_list(page, zone, order, migratetype);

    /* Notify page reporting subsystem of freed page */
    if (!(fpi_flags & FPI_SKIP_REPORT_NOTIFY))
        page_reporting_notify_free(order);
}
처음의 accounting은 ISOLATE가 아닌 반환 범위를 free로 반영하고, compaction capture가 그 범위를 가져가면 대응하는 양을 다시 뺍니다. 합병 자체는 기존 buddy를 list에서 제거하면서 진행합니다. 기존 buddy까지 새로운 free로 중복 가산하는 구조가 아닙니다. guard page와 일반 buddy도 서로 다른 제거 작업을 사용합니다.
find_buddy_page_pfn()이 실패한 뒤에는 done_merging으로 이동합니다. 성공했더라도 pageblock 크기 이상에서 특수 type 경계를 넘을 수 없다면 중단합니다. 합병할 때는 낮은 시작 PFN을 선택하고 descriptor 위치와 order를 함께 바꿉니다. buddy_pfn을 0으로 초기화한 것은 이 tag의 실제 정의이며, 다른 excerpt의 선언을 임의로 완성한 것이 아닙니다.
static inline bool
buddy_merge_likely(unsigned long pfn, unsigned long buddy_pfn,
           struct page *page, unsigned int order)
{
    unsigned long higher_page_pfn;
    struct page *higher_page;

    if (order >= MAX_ORDER - 2)
        return false;

    higher_page_pfn = buddy_pfn & pfn;
    higher_page = page + (higher_page_pfn - pfn);

    return find_buddy_page_pfn(higher_page, higher_page_pfn, order + 1,
            NULL) != NULL;
}
여기서 검사하는 대상은 현재 order의 짝을 합친 것으로 가정했을 때 만들어질 다음 order block의 buddy입니다. MAX_ORDER - 2 이상에서는 더 높은 두 단계의 여유가 없어 heuristic을 사용하지 않습니다. tail 배치는 다음 allocation에 먼저 소비되는 것을 늦추려는 선택일 뿐, 아직 free가 아닌 이웃을 예약하지 않습니다.
Free 전용 flag와 sanitizer 조건은 별개입니다
아래는 같은 파일의 fpi_t와 FPI 정의 전체입니다. SPDX는 GPL-2.0-only입니다.
typedef int __bitwise fpi_t;

/* No special request */
#define FPI_NONE        ((__force fpi_t)0)

/*
 * Skip free page reporting notification for the (possibly merged) page.
 * This does not hinder free page reporting from grabbing the page,
 * reporting it and marking it "reported" -  it only skips notifying
 * the free page reporting infrastructure about a newly freed page. For
 * example, used when temporarily pulling a page from a freelist and
 * putting it back unmodified.
 */
#define FPI_SKIP_REPORT_NOTIFY    ((__force fpi_t)BIT(0))

/*
 * Place the (possibly merged) page to the tail of the freelist. Will ignore
 * page shuffling (relevant code - e.g., memory onlining - is expected to
 * shuffle the whole zone).
 *
 * Note: No code should rely on this flag for correctness - it's purely
 *       to allow for optimizations when handing back either fresh pages
 *       (memory onlining) or untouched pages (page isolation, free page
 *       reporting).
 */
#define FPI_TO_TAIL        ((__force fpi_t)BIT(1))

/*
 * Don't poison memory with KASAN (only for the tag-based modes).
 * During boot, all non-reserved memblock memory is exposed to page_alloc.
 * Poisoning all that memory lengthens boot time, especially on systems with
 * large amount of RAM. This flag is used to skip that poisoning.
 * This is only done for the tag-based KASAN modes, as those are able to
 * detect memory corruptions with the memory tags assigned by default.
 * All memory allocated normally after boot gets poisoned as usual.
 */
#define FPI_SKIP_KASAN_POISON    ((__force fpi_t)BIT(2))
FPI_SKIP_REPORT_NOTIFY는 새로 반환한 범위의 reporting 알림만 생략합니다. reporting subsystem이 나중에 해당 범위를 가져가 처리하는 것까지 금지하지 않습니다. FPI_TO_TAIL은 shuffle보다 우선하지만 최적화용 배치 요청이며 correctness의 필수 전제로 사용하면 안 됩니다.
실제 poison 생략 조건도 should_skip_kasan_poison() 전문으로 확인할 수 있습니다.
static inline bool should_skip_kasan_poison(struct page *page, fpi_t fpi_flags)
{
    return deferred_pages_enabled() ||
           (!IS_ENABLED(CONFIG_KASAN_GENERIC) &&
        (fpi_flags & FPI_SKIP_KASAN_POISON)) ||
           PageSkipKASanPoison(page);
}
deferred page initialization, GENERIC KASAN이 아닌 경우의 FPI 요청, descriptor에 기록한 skip 상태는 각각 다른 조건입니다. allocation GFP bit의 configuration 조건을 이 내부 FPI type에 그대로 적용할 수는 없습니다. poison을 생략해도 mapping·reference·flag 검사와 다른 준비 절차가 모두 없어지는 것은 아닙니다.
shuffle도 compile-time 설정 하나만으로 항상 동작하지 않습니다. mm/shuffle.h의 SHUFFLE_ORDER는 MAX_ORDER - 1이고, CONFIG_SHUFFLE_PAGE_ALLOCATOR가 켜진 정의는 runtime static key까지 검사합니다. 아래 두 함수는 각각 해당 configuration 분기의 실제 전문이며 SPDX는 GPL-2.0입니다.
#define SHUFFLE_ORDER (MAX_ORDER-1)
CONFIG_SHUFFLE_PAGE_ALLOCATOR=y인 분기입니다.
static inline bool is_shuffle_order(int order)
{
    if (!static_branch_unlikely(&page_alloc_shuffle_key))
        return false;
    return order >= SHUFFLE_ORDER;
}
해당 설정이 없는 분기입니다.
static inline bool is_shuffle_order(int order)
{
    return false;
}
조건 자체는 >= 비교지만 정상 buddy order의 상한도 함께 적용됩니다. 특정 build에서 보이는 order 10을 모든 architecture와 configuration의 규칙으로 일반화하지 않습니다.
마지막 참조가 사라지는 시점, PCP에서 재사용 가능해지는 시점, buddy에서 합병 가능한 시점을 구별하면 free memory가 늘어도 큰 allocation이 바로 성공하지 않는 이유를 설명할 수 있습니다. 반환의 정확성은 refcount 하나가 아니라 각 단계의 소유권·동기화·분류 규칙을 지키는 데서 나옵니다.
참고 자료
- Lorenzo Stoakes, The Linux Memory Manager, Early Access, 2025, Physical Memory 장.
- Linux
v6.1: __free_pages·PCP drain·__free_one_page·FPI·buddy_merge_likely, folio 반환과 release_pages, 참조 helper, free API의 header 계약.